Линейки с возможностью масштабирования (Scale: 1-1000), есть возможность показать позицию курсора на линейке (Hairline). Линейка имеет 4 позиции размещения (сверху, снизу, слева, справа). В архиве с компонентом есть пример, в нем все очень хорошо продемонстрировано.
Вторая часть серии статей "Использование регулярных выражений в PHP" посвящена решению ряда проблем обработки сложных текстов с помощью "продвинутых" операторов регулярных выражений.
Несмотря на то, что термины данные и информация используются взаимозаменяемо, между ними есть существенная разница. Данные существуют реально. Данные — - это список температур, перечень недавних продаж или опись товара, имеющегося в наличии. Информация — это прогнозы. Информация — это предсказание погоды, прогноз прибылей и убытков и тенденции сбыта. Данные записываются в виде нулей и единиц, в то время как информация обрабатывается мозгом.
Между данными и информацией располагается приложение: механизм, который преобразует одно в другое и наоборот. Например, при покупке книги в Интернете это приложение преобразует вашу информацию — название книги, идентификатор, информацию о банковском счете — в данные: номер заказа, цену со скидкой, характеристики транзакции с использованием кредитной карточки и количество оставшихся в наличии экземпляров книги. Аналогичным образом, приложение преобразует данные в запрос на выборку со склада, отметку об отгрузке и номер отслеживания — информацию, необходимую для реализации продажи.
В действительности сложность создания приложения прямо пропорциональна преобразованиям, которые оно выполняет. Гостевая книга Web-сайта, передающая имя и адрес в поля базы данных, устроена элементарно. С другой стороны, онлайновый магазин, который передает большое количество видов информации в модель данных коммерческой сделки и преобразует данные в информацию для реализации процесса принятия решений, достаточно сложен с точки зрения разработки. Искусство программирования заключается в умелом манипулировании данными и информацией — мастерство, схожее с фиксацией света в живописи.
Как было сказано в первой части, регулярные выражения являются одним из самых мощных средств манипулирования данными. Регулярные выражения лаконично описывают форму данных и раскладывают их на составляющие. Например, следующее регулярное выражение можно использовать для обработки температуры, заданной в градусах по Цельсию или по Фаренгейту: /^([+-]?[0-9]+)([CF])$/.
Регулярное выражение сравнивает начало строки (отображается знаком "крышка" (^), за которым идет знак "+", знак "-", или ничего ([+-]?), за которым следует целое число ([0-9]+), обозначение шкалы — Цельсия или Фаренгейта ([CF]) — и заканчивается концом строки (обозначается знаком доллара $).
В данном регулярном выражении операторы начала строки и конца строки представляют собой примеры операторов нулевой ширины или совпадений по положению, а не по символам. Круглые скобки также не указывают на символы. Зато, если заключить шаблон в круглые скобки, то будет извлечен текст, соответствующий шаблону. Следовательно, если текст полностью сопоставим с шаблоном, то первая пара круглых скобок выдаст строку, представляющую собой положительное или отрицательное целое число, например, +49, а вторая пара круглых скобок - или букву C, или F.
В первой части серии представлено понятие регулярного выражения и были описаны PHP-функции для сравнения текста с шаблонами, а также для извлечения совпадений. А теперь давайте углубимся в изучение регулярных выражений и посмотрим на некоторые "продвинутые" операторы и средства.
Круглые скобки опять приходят на помощь
В большинстве случаев пара круглых скобок используется для описания части шаблона и получения текста, соответствующего этой части. Однако от круглых скобок не всегда требуется получение части шаблона. Как и в сложной арифметической формуле, круглые скобки можно использовать для группировки условий.
Приведу пример. Догадаетесь, какому типу данных соответствует данное выражение?
/[-a-z0-9]+(?:\.[-a-z0-9]+)*\.(?:com|edu|info)/i
Как можно догадаться, это регулярное выражение определяет имена Интернет-сайтов (только для доменов .com, .edu, и .info). Отличием является использование дополнительного оператора ?:. Квалификатор части шаблона ?: отключает функцию извлечения данных, и тем самым дает круглым скобкам возможность обозначать последовательность действий. Например, в данном случае фраза (?:\.[-a-z0-9]+)* соответствует нулю или более элементам строки, например, ".ibm." Аналогично, фраза \.(?:com|edu|info) обозначает последовательность символов, за которой идет одна из строк com, edu, или info.
Отключение функции извлечения информации может показаться бессмысленным, если не подумать о том, что извлечение информации требует дополнительной обработки. Если программа обрабатывает большое количество данных, то отказ от извлечения может быть целесообразным. Кроме того, если вы имеете дело со сложным регулярным выражением, то отключение функции извлечения информации в некоторых частях шаблона может упростить извлечение тех частей шаблона, которые реально нужны.
Примечание: Модификатор i в конце регулярного выражения делает все сопоставления с шаблоном нечувствительными к регистру. Следовательно, подмножество a-z будет сопоставимо со всеми буквами, независимо от регистра.
В PHP есть и другие модификаторы частей шаблона (subpattern). Используя отладчик регулярных выражений, показанный в первой части данной серии (повторно показан в листинге 1), попробуйте сопоставить регулярное выражение ((?i)edu) со строками "EDU," "edu," и "Edu." Если в начале части шаблона задать модификатор (?i), то сопоставление с шаблоном не будет зависеть от регистра. Чувствительность к регистру восстанавливается, как только заканчивается данная часть шаблона. (Сравните с модификатором / ... /i, который применяется ко всему шаблону.)
Листинг 1. Простой отладчик регулярных выражений
Еще один полезный модификатор части шаблона - это (?x). Он позволяет добавлять в шаблон пробелы, что упрощает чтение регулярных выражений. Таким образом, часть шаблона ((?x) edu | com | info) (обратите внимание на пробелы между операторами дизъюнкции, которые добавлены для удобочитаемости) аналогична (edu|com|info). Для того, чтобы добавлять пробелы и комментарии в регулярное выражение, можно использовать глобальный модификатор / ... /x, см. листинг ниже.
Листинг 2. Добавление пробелов и комментариев
Как видно из листинга, при необходимости модификаторы можно объединять. Если необходимо включить в регулярное выражение символ пробела при использовании модификатора (?x), используйте метасимвол \s для поиска любого пробельного символа и \ (обратный слеш с пробелом) для поиска одного пробела, например, ((?x) hello \ there).
Оглядываемся вокруг
В подавляющем большинстве случаев регулярные выражения используются для проверки или декомпозиции входной информации на отдельные "лакомые кусочки", которые записываются в архив данных или сразу же обрабатываются приложением. Общепринятыми сферами применения являются: обработка полей форм, парсинг XML-кода и анализ протоколов.
Еще одна область применения регулярных выражений - форматирование, нормализация или улучшение читаемости данных. Вместо того чтобы использовать регулярные выражения для поиска и извлечения текста, при форматировании они применяются для поиска и вставки текста в надлежащее местоположение.
Вот пример полезного применения форматирования. Предположим, что Web-форма передает приложению значение зарплаты с округлением до целого доллара. Так как зарплата хранится в виде числа целого типа, то перед сохранением переданных данных приложение должно удалять из них знаки пунктуации. Однако при извлечении данных из хранилища, возможно, понадобится изменить их формат и сделать удобочитаемыми с помощью разделителей. В листинге 3 показано, как простой PHP-запрос преобразует сумму в долларах в число.
Листинг 3. Преобразование суммы в долларах в число
Вызов функции preg_replace() заменяет знак доллара, любой пробельный символ и все запятые -- на пустую строку, возвращая то, что предположительно является целым числом. Если проверка функцией is_numeric() подтверждает правильность входных данных, их можно сохранить.
А теперь давайте выполним обратную операцию - добавим к числу знак денежной единицы и запятые-разделители сотен, тысяч и миллионов. Для добавления запятых в определенных позициях можно написать программу для поиска этих компонентов, а можно воспользоваться операторами посмотри вперед и посмотри назад. Модификатор части шаблона ?<= обозначает посмотри назад (то есть влево) от текущей позиции. Модификатор ?= означает "посмотри вперед" (то есть вправо) от текущей позиции.
[pagebreak]
Итак, какие позиции нам нужны? Любое место в строке, при условии, что есть как минимум один символ слева и одна или более групп по три символа справа, не считая десятичной точки и количества центов. Соблюдая это правило и используя два модификатора, анализирующих символы справа и слева от определенной позиции и являющихся операторами нулевой ширины, мы можем достичь цели с помощью следующей инструкции:
Как работает это регулярное выражение? Начиная с первого символа строки и обрабатывая каждый символ, регулярное выражение отвечает на вопрос: "Есть ли хотя бы один символ слева и одна или несколько групп из трех символов справа?" Если да, то наш оператор нулевой ширины заменяется запятой.
Большинство сложных сопоставлений можно реализовать, используя стратегию, аналогичную приведенной выше. Например, вот еще один вариант использования оператора "посмотри вперед", который решает широко распространенную дилемму.
Листинг 4. Пример использования оператора "посмотри вперед" ("предвидение")
Оператор preg_replace() преобразует строку данных, разделенных запятыми, в строку данных, разделенных знаком табуляции. Предусмотрительным образом, он не заменяет запятые в строке, заключенной в кавычки.
Это регулярное выражение при каждом обнаружении запятой (на это указывает запятая в самом начале регулярного выражения) проверяет утверждение: "Впереди не было кавычек или было четное количество кавычек". Если утверждение верно, то запятую можно заменить знаком табуляции (the \t).
Если Вам не нравятся операторы «посмотри вперед» и «посмотри назад» или вы работаете с таким языком, в котором их нет, можно добавить запятые в число и с помощью обычного регулярного выражения. Однако для реализации такого решения потребуется много итераций.
Листинг 5. Добавление запятых
Давайте пройдем по коду. Сначала параметр зарплаты очищается от знаков пунктуации для моделирования ситуации чтения целого числа из базы данных. Затем выполняется цикл в поисках позиций, где за одним числовым символом ((\d) идут три числовых символа ((\d\d\d\): если обнаруживается граница слова, заданная как \b, цикл прекращается. Граница слова -- это еще один оператор нулевой ширины, который соответствует следующим позициям:
* Перед первым символом строки, если это буква слова.
* За последним символом строки, если это буква слова.
* Между буквой слова и небуквенным символом, непосредственно за буквой слова.
* Между небуквенным символом и буквой слова, непосредственно за небуквенным символом.
Таким образом, примерами правильных границ слова являются пробел, точка и запятая.
Благодаря внешнему циклу регулярное выражение перемещается слева направо в поисках цифры, за которой идут три цифры и граница слова. При обнаружении совпадения между двумя частями шаблона добавляется запятая. Цикл должен продолжаться до тех пор, пока оператор preg_replace() находит совпадения, что задано в условии $old != $pretty_print.
Жадность и лень
Регулярные выражения обладают большими возможностями, иногда даже слишком большими. Например, давайте рассмотрим, что произойдет, если регулярное выражение ".*" будет обрабатывать строку "The author of 'Wicked' also wrote 'Mirror, Mirror.'" Вероятно, вы предполагаете, что preg_match() вернет два совпадения, и с удивлением обнаружите, что результат всего один: 'Wicked' also wrote 'Mirror, Mirror.'
Почему? Если не задать иное, то такие операторы как * (ноль или более) и + (один или более) -- "жадные". Если сопоставление с образцом может продолжаться, то они и будут его продолжать до тех пор, пока не будет возвращен максимальный результат из возможных. Для сохранения минимальных совпадений необходимо принудительно заставлять определенные операторы быть "ленивыми". "Ленивые" операторы находят самое короткое совпадение и на этом останавливаются. Чтобы сделать оператор более "ленивым", добавьте суффикс в виде знака вопроса. Пример показан в листинге 6.
Листинг 6. Добавление суффикса в виде знака вопроса
Регулярное выражение ".*?" расшифровывается следующим образом: "найти кавычку, за которой идет ровно столько символов с последующей кавычкой.
Однако иногда оператор * может быть слишком "ленивым". Например, посмотрите на следующий фрагмент кода. Что он делает?
Листинг 7. Простой отладчик регулярных выражений
Что вы загадали? "123"? "1"? Нет результата? На самом деле результатом будет Array ( [0] => [1] => ), означающий, что совпадение было найдено, но никаких данных извлечено не было. Почему? Вспомните, что оператор * ищет совпадения с нулем или более символов. В данном случае, выражение [0-9]* находит совпадение с нулем символов от начала строки, и обработка заканчиваетс.
Для решения данной проблемы добавьте оператор нулевой ширины для привязки совпадения, который заставляет регулярное выражение продолжать сопоставления; /([0-9]*\b/.
Советы и рекомендации
С помощью регулярных выражений можно решать как простые, так и сложные задачи при обработке текста. Начните с небольшой группы операторов и по мере того, как вы будете набираться опыта, расширяйте свой словарь. В качестве вознаграждения за ваши старания -- некоторые советы и рекомендации.
Создание переносимых регулярных выражений с помощью классов символов
Вам уже знакомы метасимволы, например, \s - соответствует любому пробельному символу. Кроме того, большинство реализаций регулярных выражений поддерживает предопределенные классы символов, которые более просты в использовании и переносимы с одного письменного языка на другой. Например, класс символов [:punct:] замещает все символы пунктуации в данном языке. Вместо [0-9] можно использовать [:digit:] и более переносимое замещение [:alpha:] вместо [-a-zA-Z0-9_]. Например, можно убрать все знаки пунктуации, используя:
Класс символов представляет собой более сжатую форму по сравнению с подробным описанием всех символов пунктуации. Полный перечень классов символов можно найти в документации по версии языка PHP.
Как исключить то, что вы не ищете
Как показано в примере с данными, разделенными символом табуляции, в качестве значений, разделенных запятыми (CSV), иногда проще и точнее задать список тех вариантов, которые не нужно находить (сопоставлять). Последовательность, начинающаяся со знака "крышка" (^) будет соответствовать любому символу, не принадлежащему данной последовательности. Например, для проверки правильности телефонных номеров для США можно использовать регулярное выражение /[2-9][0-9]{2}[2-9][0-9]{2}[0-9]{4}/. Используя набор ограничений можно написать регулярное выражение в более явном виде /[^01][0-9]{2}[^01][0-9]{2}[0-9]{4}/. Оба регулярных выражения работают, хотя смысл последнего, вероятно, более понятен.
Пропуск новой строки
Если во входных данных несколько строк, стандартного регулярного выражения будет недостаточно, так как сканирование прекращается на начале новой строки, которая обозначается $. Однако, если воспользоваться модификаторами s или m, то регулярное выражение будет обрабатывать входные данные по-другому. Первый модификатор рассматривает строковую последовательность как одну строку, где точка указывает на начало новой строки (обычно она этого не делает). Второй рассматривает строковую последовательность как несколько строк, где ^ и $ соответствуют началу и концу любой строки, соответственно. Приведем пример. Если задать $string = "Hello,\nthere";, то оператор preg_match( "/.*/s", $string, $matches) параметру $matches[0] присвоит значение Hello,\nthere. (При удалении s будет выдано Hello.)
Примечание - большая часть написанного здесь текста с примерами взята по памяти (пару лет назад изучал достаточно подробно, поэтому может что-то в алгоритмах не работать - я ведь их не копировал откуда-то, а прямо тут же и писал, так что за синтаксические ошибки не пинайте) - на данный момент я активно OLE не пользуюсь (не из-за каких-то проблем с самим OLE, а из-за отсутствия надобности в его использовании в текущий момент).
Основные преимущества, благодаря которым OLE активно используется:
* Для вызывающей базы "по барабану" - какой тип вызываемой базы (DBF или SQL)
* Объектами вызываемой базы можно управлять всеми известными методами работы с объектами в 1С (т.е. со справочниками работают методы ВыбратьЭлементы(), ИспользоватьДату() и т.п., с документами - ВыбратьДокументы() и т.п.), соответственно, можно напрямую решить - стоит отрабатывать конкретные объекты базы OLE или пропустить их.
Пример 1. Присоединение к базе 1С через OLE.
БазаОле=СоздатьОбъект("V77.Application"); // Получаем доступ к OLE объекту 1С
Локальная версия (на одного пользователя): V77L.Application
Сетевая версия: V77.Application
Версия SQL: V77S.Application
Далее вместо термина "вызываемая база" будет написано просто "база OLE", а вместо термина "вызывающая база" - "местная база"
Теперь, мы должны знать несколько параметров для запуска базы OLE: Каталог базы, имя пользователя и пароль. Ну, наверное, еще и желание запустить 1С в монопольном режиме :)
Комментарий: функции СокрЛП() стоят в примере на случай, если пользователь захочет указанные выше переменные сделать в форме диалога, а проблема при этом состоит в том, что в алгоритм программа передаст полное значение реквизита (т.е. допишет в конце значения то количество пробелов, которое необходимо для получения полной длины строки (указана в свойствах реквизита диалога)).
Пример 2. Доступ к объектам базы OLE.
Запомните на будущее как непреложный факт:
1. Из местной базы в базу OLE (и, соответственно, наоборот) напрямую методом присвоения можно перенести только числовые значения, даты и строки ограниченной длины!!! Т.е. местная база поймет прекрасно без дополнительных алгоритмов преобразования полученного значения только указанные типы значений. Кроме того, под ограничением строк подразумевается проблемы с пониманием в местной базе реквизитов объектов базы OLE типа "Строка неограниченной длины". К этому же еще надо добавить и периодические реквизиты. Естественно, под методом присвоения подразумеваются и попытки сравнить объекты разных баз в одном условии (например, в алгоритмах "Если" или "Пока" и т.п.).
2. Есть проблемы при попытке перенести "пустую" дату - OLE может ее конвертировать, например, в 31.12.1899 года и т.п. Поэтому вам лучше заранее выяснить те значения, которые могут появится в местной базе при переносе "пустых" дат, чтобы предусмотреть условия преобразования их в местной базе.
A) Доступ к константам базы OLE:
Б) Доступ к справочникам и документам базы OLE (через функцию "CreateObject"):
После создания объекта справочника или документа к ним применимы все методы, касающиеся таких объектов в 1С:
Заметьте, что если вместо "Сообщить(Спр.Наименование)" вы укажете "Сообщить(Спр.ТекущийЭлемент())", то вместо строкового/числового представления этого элемента программа выдаст вам в окошке сообщение "OLE". Именно это я и имел в виду, когда говорил, что напрямую мало что можно перенести. Т.е. не будут работать следующие методы (ошибки 1С не будет, но и результат работы будет нулевой). Рассмотрим следующий пример:
Однако, сработает следующий метод:
Отсюда вывод: возможность доступа к объектам базы 1С через OLE требуется, в основном, только для определенной задачи - получить доступ к реквизитам определенного элемента справочника или документа. Однако, не забываем, что объекты базы OLE поддерживают все методы работы с ними, в т.ч. и "Новый()", т.е. приведем пример противоположный предыдущему:
В) Доступ к регистрам базы OLE (Не сложнее справочников и документов):
Г) Доступ к перечислениям базы OLE (аналогичен константе):
ЗначениеПеречисленияOLE = БазаОле.Перечисление.Булево.НеЗнаю; // :)
Заметьте, что пользы для местной базы от переменной "ЗначениеПеречисленияOLE" особо-то и нет, ведь подобно справочнику и документу перечисление также напрямую недоступно для местной базы. Пожалуй, пример работы с ними может быть следующим (в качестве параметра условия):
По аналогии со справочниками и документами работает объект "Периодический", план счетов работает по аналогии с ВидомСубконто, ну и далее в том же духе… Отдельную главу посвятим запросу, а сейчас… стоп. Еще пункт забыл!
Ж) Доступ к функциям и процедурам глобального модуля базы OLE!
Как же я про это забыл-то, а? Поскольку при запуске базы автоматически компилируется глобальный модуль, то нам становятся доступны функции и процедуры глобального модуля (поправлюсь - только те, у которых стоит признак "Экспорт"). Плюс к ним еще и различные системные функции 1С. А доступны они нам через функцию 1С OLE - EvalExpr(). Приведем примеры работы с базой OLE:
На самом деле, в последней строке примера я исхитрился и забежал немного вперед. Дело в том, что как и запрос (см. отдельную главу), так и EvalExpr() выполняются внутри базы OLE, причем команды передавается им обычной строкой, и поэтому надо долго думать, как передать необходимые ссылки на объекты базы OLE в строке текста местной базы. Так что, всегда есть возможность поломать голову над этим…
Алгоритмы преобразования объектов в "удобоваримый вид" между базами.
Ясно, что алгоритмы преобразования нужны не только для переноса объектов между и базами, но и для такой простой задачи, как попытки сравнить их между собой.
И еще раз обращу внимание: ОБЪЕКТЫ ОДНОЙ БАЗЫ ПРЕКРАСНО ПОНИМАЮТ ДРУГ ДРУГА, ПРОБЛЕМЫ ВОЗНИКАЮТ ТОЛЬКО ТОГДА, КОГДА ВЫ НАЧИНАЕТЕ СВЯЗЫВАТЬ МЕЖДУ СОБОЙ ОБЪЕКТЫ РАЗНЫХ БАЗ, т.е. команда
будет прекрасно работать без ошибок. Не забывайте это, чтобы не перемудрить с алгоритмами!
Итак, повторяюсь, что напрямую перенести, да и просто сравнить можно только даты (причем не "пустые"), числа и строки ограниченной длины. Итак, как же нам сравнить объекты разных баз (не числа, не даты, не строки), т.е. как их преобразовать в эту самую строку/число/дату.
А) Преобразование справочников/документов базы OLE (если есть аналогичные справочники/документы в местной базе). В принципе, преобразование их было уже рассмотрено в примерах выше и сводится к поиску их аналогов в местной базе. Могу еще раз привести пример, заодно с использованием регистров:
Б) Преобразование перечислений и видов субконто (подразумевается, что в обоих базах есть аналогичные перечисления и виды субконто). Вся задача сводится к получению строкового или числового представления перечисления или вида субконто.
Не поймите это как прямую команду воспользоваться функцией Строка() или Число() :)) Нет. Для этого у нас есть обращение к уникальному представлению перечисления и вида субконто - метод Идентификатор() или ЗначениеПоНомеру(). Второй вариант не очень подходит, так как зачастую в разных базах даже перечисления бывают расположены в другом порядке, а вот идентификаторы стараются держать одинаковыми в разных базах. Отсюда вывод, пользуйтесь методом Идентификатор(). Кстати, не путайте вид субконто с самим субконто! Привожу пример преобразования:
То же самое относится и к плану счетов - принцип у него тот же, что и у вида субконто…
В) Преобразование счетов:
Во многом объект "Счет" аналогичен объекту "Справочник". Отсюда и пляшем:
Работа с запросами и EvalExpr().
Наконец-то добрались и до запросов. Надо пояснить несколько вещей, касаемых запросов (да и EvalExpr() тоже). Самое главное - компиляция текста OLE-запроса (т.е. разбор всех переменных внутри запроса), как и сами OLE-запросы выполняются внутри базы OLE и поэтому ни одна переменная, ни один реквизит местной базы там недоступны, да и запрос даже не подозревает, что его запускают по OLE из другой базы!!! Поэтому, чтобы правильно составить текст, иногда требуется не только обдумать, как передать параметры запроса в базу OLE, но и обдумать, что нужно добавить в глобальный модуль той самой OLE-базы, чтобы как-то собрать для запросы переменные!
1. Поскольку сам текст запроса и функции EvalExpr() является по сути текстом, а не набором параметров, то напрямую передать ему ссылку на элемент справочника, документ, счет и т.п. нельзя. Исключение может быть составлено для конкретных значений перечислений, видов субконто, констант, планов счетов и т.п.
2. Хоть и многим и так понятно, что я скажу дальше, но я все-таки уточню: при описании переменных в тексте запроса не забывайте, что объекты базы надо указывать напрямую, без всяких префиксов типа "БазаОле".
3. Отрабатывать запрос сложно тем, что ошибки, например, при компиляции напрямую не увидеть. Поэтому начинаем пошагово готовится к отработке запроса в базе OLE.
Вначале допишем в глобальном модуле базы OLE немного строк, которые нам помогут в работе:
Теперь начинаем потихоньку писать сам запрос. Что мы имеем:
В форме диалога местной базы несколько реквизитов диалога (либо местные переменные):
* Даты периода (НачДата и КонДата)
* Элементы справочников для фильтрации (ВыбТовар, ВыбФирма, ВыбКлиент, и т.д.)
* Какие-либо флажки (ТолькоЗамерзающийЗимойТовар , ..)
Мы начинаем писать запрос и сразу попадаем в такую ловушку:
ТекстЗапроса = " Период с НачДата по КонДата; ";
Вроде все в порядке, но такой запрос не выполнится в базе OLE, так как там понятия не имеют, что такое НачДата и КонДата :)) Ведь эти переменные действительны только для местной базы! Переписываем запрос заново:
Казалось бы все очень просто. По аналогии - если уникальность для товаров ведется по наименованию, то простой заменой слова "код" на "наименование" мы решаем вопрос и здесь. Теперь рассмотрим, когда мы выбрали группу, т.е. текст условия должен будет выглядеть так:
И здесь, правда можно проблему решить "двумями путями" :)) Первый пусть - когда мы имеем дело с двухуровне вымсправочником. Тогда проблема группы решается также просто, как и в 1-м варианте:
А если справочник очень даже многоуровневый? Вот для этого мы и используем написанную ранее функцию. Предположим, что список значений запроса с индексом массива " 1 " мы будем использовать для хранения подобных значений (например, хранить в нем группы товаров, клиентов) для хитрых условий. Итак, например, в ВыбТовар у нас указана группа товаров, а в ВыбКлиент - группа клиентов, которым мы товары группы ВыбТовар продавали. Кроме того, мы должны пропустить накладные возвратов поставщикам, и не забыть, что товары надо еще отбирать по флажку ТолькоЗамерзающийЗимойТовар:
Ну, а с реквизитами запроса разбираемся так же, как указано было выше в предыдущих разделах… И не забываем, что кроме хранения конкретных значений, можно использовать другие списки значений запроса. Например, можно заполнить какой-либо список значений запроса списком клиентов и использовать его в запросе:
Настройки по умолчанию в Кореле не очень удобны. В любом графическом редакторе всегда хочется иметь как можно больше рабочего пространства. Настройки по умолчанию хороши лишь для изучения редактора, так как все руководства, справка и книги написаны под них. Когда же всё изучено и опробовано, можно настроить интерфейс «под себя». А некоторые опции просто необходимо скорректировать для комфортной работы.
Настраиваем сами Corel Draw.
Настройки по умолчанию в Кореле не очень удобны. В любом графическом редакторе всегда хочется иметь как можно больше рабочего пространства. Настройки по умолчанию хороши лишь для изучения редактора, так как все руководства, справка и книги написаны под них. Когда же всё изучено и опробовано, можно настроить интерфейс «под себя». А некоторые опции просто необходимо скорректировать для комфортной работы.
Для настройки интерфейса обычно используют меню Customization. Но в этой статье часто будет использоваться ещё один способ. Заключается он в том, что элементы интерфейса можно перетаскивать, зажав клавишу Alt, если при перетаскивании воспользоваться сочетанием Ctrl+Alt то перемещаемые элементы дублируется. Чтобы просто удалить элемент достаточно кликнуть на нем правой кнопкой мыши и в появившемся контекстном меню выбрать Customize>Toolbar Item>Delete. Сами «бары» перетаскиваются за двойную линию с левого или верхнего края.
Настройка внешняя.
Удаляем всё лишнее.
В верхней части интерфейса находятся Menu Bar (стандартные File, Edit, View и т.д.), Standard toolbar (панель, где находятся пиктограммы New, Open, Save...) и Property Bar (панель свойств, где устанавливаются параметры страницы, единицы измерения и прочие параметры документа). Menu Bar имеет привычное для большинства Windows приложений расположение, поэтому можно оставить его без изменений. Сэкономить место, здесь можно разместив Standard toolbar и Property Bar в один ряд, что станет возможно, если удалять с Standard toolbar. Лишние элементы, начиная, справа это выпадающее меню масштаба (zoom level), которое дублируется при выбранном Zoom Tool`е, затем кнопки «Access the Corel Graphics Community Web site» и «Start Corel applications», кнопки импорта и экспорта заменят легко запоминающиеся сочетания Ctrl+I и Ctrl+E. Всем знакомы такие сочетания как Ctrl+Z и Ctrl+Shift+Z, соответственно кнопкам со стрелочками «Undo» и «Restore» не место в новом интерфейсе. Опять же копирование/вставка – стандартные во всех приложениях Ctrl+C/X/V, да и в контекстном меню они присутствуют, так что тоже можно смело удалять. В общем, что оставить в Standard toolbar`е и оставлять ли его вообще дело индивидуальное, главное поставить его вряд с Property Bar`ом, что расширит рабочую область аж на 32 пиксела. Беспокоится о неправильных действиях и удалении чегото нужного сильно не стоит. Стандартные панели можно вернуть к прежнему виду в меню Tools>Customization>Command Bars, выделив нужную и нажав кнопку Reset. Либо через контекстное меню Customize>[Toolbar Name]>Reset to Default. Сбросить же все настройки на дефолтные если вдруг ваши эксперименты совсем выйдут из под контроля можно стартовав CorelDRAW с зажатой клавишей F8. То что находится внизу называется Status Bar и по умолчанию занимает неоправдано много места, показывая такие ненужные вещи как позиция курсора, доступные команды для инструментов и свойства объектов которые дублируются на панели свойств. Удалив все лишнее можно разместить вряд Object Information, Object Detalis, Fill Color и Outline color таким образом уменьшив размер панели состояния вдвое.
Ну и наконец немного расширить рабочую область можно отключив линейки, двойной клик и в появившемся окне снять галочку Show Rulers, существенный минус это отсутствие возможности вытягивать из них направляющие (Guidelines) и выставлять нулевые координаты в нужное место. Как вариант можно вынести кнопку включения/отключения линеек в какое-нибудь удобное место, находится она в меню Tools>Customization>Commands выпадающем списке View и называется Rulers.
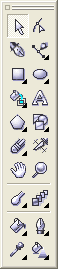
Панель инструментов (Toolbox).
Та часть интерфейса, в которой расположены инструменты (Pick, Zoom, Shape, Bezier Tools и т.д.) интерактивные эффекты (Blend, Transparency, Envelope и т.д.) и прочее необходимое в работе и есть Toolbox или панель инструментов. По умолчанию она расположена неподвижно в крайней левой части окна и все инструменты расположены в один столбик, а некоторые объеденены в группы. Такой порядок не очень удобен опытному пользователю и уж тем более профессионалу или векторному маньяку.
Расположение в два столбика более практично и удобно, с этого и следует начать – перетащить Toolbox за верхний край со стандартного места в свободную область и растянуть до расположения инструментов в два столбца. Теперь руководствуясь собственным опытом и манерой работы нужно выставить инструменты в нужном порядке. Например Shape Tool можно вынести отдельно от группы и расположить рядом с Pick Tool`ом, также с инструментом Hend, а в выпадающих группах подвинуть наиболее используемые инструменты ближе к левому краю.
Чтобы новая панель выглядела аккуратней можно убрать верхнюю часть с названием и крестиком закрытия, для этого нужно кликнуть на панели правой кнопкой мыши, в контекстном меню выбрать Customize>Toolbox Toolbar>Properties... и в появившемся окне снять галочку «Show title when toolbar is floating».
Докеры (Dockers).
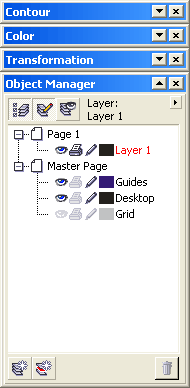
Особенностью интерфейса CorelDRAW является то что многие полезные функции и эффекты реализованы в виде докеров – панелей по умолчанию открывающихся справа. Там им самое место, вот только открывать каждый раз нужный докер не очень удобно, располагаются они в разных частях меню, хотя почти все их можно найти в меню Window>Dockers и на многие уже назначены сочетания клавиш. Наиболее удобный выход держать их открытыми, только в свернутом состоянии, так они будут расположены в нужном порядке удобными вкладками и при надобности разворачиваться одним кликом и так же легко сворачиваться. Определившись с наиболее удобным порядком (чтобы чаще используемые были выше) нужно поочередно открыть их через меню Window>Dockers. После этих действий правая часть экрана будет занята набором удобных закладок.
При желании расположить их можно и не привязывая к экрану, перетаскиваются они также как и другие элементы. В «плавающем» состоянии докеры представляют собой отдельные окошки, напоминающие аналогичные в «Адобовских» продуктах, которые так же легко сворачиваются и объединяются в группы.
Палитру цветов так же можно расположить более удобно, горизонтально например или в виде той же плавающей панели, форма и место расположения практически ничем не ограничиваются.
С принципом настройки интерфейса и некоторыми вариантами модификации, думаю, все понятно, она на то и кастомизация чтобы каждый мог изменить рабочее пространство на удобное ему. Теперь о настройках внутренних.
Настройка внутренняя.
Горячие клавиши.
Здесь каждый вправе сам решать что нужнее всего и достойно назначения клавиш.
В меню Tools>Customization>Commands во вкладке Shortcut Keys назначить свое сочетание клавиш можно любой функции. Совет: при установке горячих клавиш включите режим Navigate to conflict on Assign это позволит не допустить повтора уже существующих сочетаний. И ещё один важный совет: многим в Corel`е не хватает аналога функции Hand Tool в Photoshop`е и Illustrator`е, которой можно перемещаться по рабочей области зажав пробел не отрываясь от основных действий и не переключая инструментов. Такая функция присутствует, но по умолчанию не задействована, исправить ситуацию можно назначив горячую клавишу инструменту Pan (можно тот же пробел) который находится в меню Tools>Customization>Commands в выпадающем списке View.
Опции.
Пройдясь по опциям можно настроить некоторые параметры, сделав работу еще более удобной и продуктивной, начнем по порядку: Tools>Options (Ctrl+J)>Workspace>General тут можно установить количество шагов отката (Undo levels) для основных операций (Regular) и операций с растрами (Bitmap effects), примерные значения 50-100 и 5-10 соответственно.
Тут же можно отключить звуки (снять пометку с Enable sounds). Вкладка Display интересна опцией Enable node Tracking знакомой по ранним версиям CorelDraw (напомню: при активном инструменте Pick Tool и наведении на узлы он превращается в Shape Tool, таким образом можно скруглять углы прямоугольников и перемещать узлы не переключаясь на шейпер). Опция удобная и многим привычная, но не всегда востребованная, а лазить каждый раз в опции для ее включения не очень удобно. Альтернатива есть: в уже знакомом меню Tools>Customization>Commands нужно выбрать в выпадающем списке Edit, найти опцию Tracking и вытащить ее в удобное место на рабочей области или назначить ей сочетание клавиш. Теперь активация функции Node Tracking займет считанные секунды.
Далее во вкладке Edit следует снять галочку с опции Edit Auto-center new PowerClip contents, эта опция размещает объект в центре контейнера поверклипа, что нужно очень редко и если уж возникла такая необходимость, решается предварительным выравниванием объектов клавишами «C» (по вертикали) «E» (по горизонтали).
Следующая вкладка обязательная к посещению Memory, тут следует увеличить объем оперативной памяти используемой приложением со стандартных 25% до 50-75% в зависимости от объема доступной памяти.
Во вкладке Text>Quick Correct нужно снять галочку с одной из самых надоедливых функций CorelDRAW «Capitalize first letter of sentence» которая всюду при наборе текста делает первую букву предложения заглавной, что совершенно не требуется в большинстве случаев.
Часто CorelDRAW импортирует файлы в формате EPS в виде растровых объектов либо не импортирует вообще, для корректного импорта необходимо использовать фильтр «EPS, PS, PRN – PostScript», можно конечно выбирать его вручную в диалоговом окне импорта в выпадающем меню Files of type, но проще назначить его фильтром по умолчанию. Для этого в меню Global > Filters в списке List of active filters нужно выделить нужный фильтр и кнопкой Move Up поднять его выше фильтра «EPS - Encapsulated PostScript». Теперь нужный фильтр будет отвечать за импорт *.eps файлов постоянно.
Ну вот пожалуй и все основные и нуждающиеся в корректировке опции. На последок можно отметить некоторые возможности рассчитанные скорей на любителя нежели необходимые в работе. В меню Customization>Commands в выпадающем списке Status Bar можно найти такие функции как Time, которая как ясно из названия показывает время, Memory Allocated, которая проинформирует о занятой открытыми файлами памяти, а также индикатор статуса привязки Snap Status, и еще ряд подобных мелочей. Их можно расположить как например в том же Status Bar так и назначать горячие клавиши, после нажатия которых информация выведется рядом с курсором.
Node Color Coding.
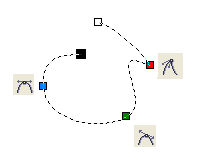
По умолчанию отключенное нововведение CorelDRAW X3 (похоже, не всегда корректно работает), из название понятно – цветовое выделение узлов, т.е. подсвечивает узлы с разными свойствами (cusp, smooth, simmetrical) своим цветом. Кроме того, выделяется «начальный» узел, что в работе с блендами весьма полезно.
Включается через реестр (Пуск>Выполнить...>regedit):
в ветке
HKEY_CURRENT_USER > Software > Corel > CorelDRAW > 13.0 > CorelDRAW > Application Preferences > Base Tool Pref
присваиваем параметру
"NodeColorCoding"
значение "1".




 Поиск