В настоящей книге показано, как ввести в компьютерную игру синтетические игровые персонажи с реалистичными формами поведения, сосредоточиваясь на отдельных аниматах (автономных созданиях с искусственным телом), находящихся в виртуальном мире. Книга посвящена описанию того, как создавать подобные автономные персонажи, основанные на использовании средств ИИ, и заставлять их интеллектуально реагировать на происходящие события. В качестве испытательной площадки применяется реалистичная трехмерная игра.
Эта книга представляет собой уникальное сочетание теоретических основ, практических рекомендаций и oпределений основных понятий, относящихся к области разработки средств ИИ, и предназначена для читателей, которые стремятся приобрести знания о средствах ИИ и применить эти знания на практике для создания игр.
От издателя: Итак, вы решили серьезно взяться за Visual C++ .NET. Это хорошая идея, ведь вы в действительности убиваете сразу трех зайцев: в ваших руках оказывается мощный, полезный и широко распространенный инструмент. С языком С++ можно сделать очень многое. С его помощью созданы такие продукты, как Hxeel и Access. 'Jror язык также применяется при разработке управленческих информационных систем и систем целевого назначения, используемых для анализа деятельности предприятий и принятия решений в сфере управления бизнесом. И. конечно же, целые армии хакеров и не только хакеров используют C++ для создания инструментов, утилит, игр и шедевров мультимедиа. Знания, которые вы получите, изучив язык C++ .NET. позволят создавать не просто приложения, а приложения, работающие в разных операционных системах. Возможности этого языка практически не ограничены, и вы сами в этом убедитесь, прочитав эту книгу.
Семейство протоколов TCP/IP широко применяется во всем мире для объединения компьютеров в сеть Internet. Единая сеть Internet состоит из множества сетей различной физической природы, от локальных сетей типа Ethernet и Token Ring, до глобальных сетей типа NSFNET. Основное внимание в книге уделяется принципам организации межсетевого взаимодействия. Многие технические детали, исторические вопросы опущены. Более подробную информацию о протоколах TCP/IP можно найти в RFC (Requests For Comments) - специальных документах, выпускаемых Сетевым Информационным Центром (Network Information Center - NIC). Приложение 1 содержит путеводитель по RFC, а приложение 2 отражает положение дел в области стандартизации протоколов семейства TCP/IP на начало 1991 года.
В книге приводятся примеры, основанные на реализации TCP/IP в ОС UNIX. Однако основные положения применимы ко всем реализациям TCP/IP.
Надеюсь, что эта книга будет полезна тем, кто профессионально работает или собирается начать работать в среде TCP/IP: системным администраторам, системным программистам и менеджерам сети.
Первоначальный вариант программы Photoshop, разработанный братьями Knoll, был приобретен компанией Adobe у фирмы BarneyScan в 1988 году. После значительного усовершенствования, в 1989 году был выпущен первый коммерческий вариант Adobe Photoshop. За прошедшие годы программа стала мировым стандартом в области обработки растровой графики, особенно с появлением версии Photoshop 4.0, выпущенной в ноябре 1996 года. Adobe Photoshop применяется при создании, ретуши и улучшении качества изображений, ее используют практически во всех технологических циклах воспроизведения и передачи изображений — от полиграфии до World Wide Web.
Редкая книга 1964 года.
Предисловие: Эта книга популярно излагает основы математической логики. Необходимость такой книги вызвана тем, что в настоящее время все большее значение приобретает автоматизация производственных процессов. Программа КПСС прямо указывает на важность автоматизации для создания материально-технической базы коммунизма. Математическая логика является теоретической основой кибернетики, а эта последняя в свою очередь применяется для решения проблема автоматизации. Несмотря на важность математической логики, в нашей стране почти нет книг, излагающих основы этой науки. Имеющиеся у нас книги по математической логике рассчитаны на читателя, достаточно математически подготовленного. Между тем необходимо создать такую книгу, которая давала бы представление о математической логике и в то же время не требовала бы для своего понимания большего, чем школьный курс математики. Данна книга, по-моему, решает эту задачу.
Настоящая книга является обработкой лекций, которые автор читал в Саратовском университете в 1962-66 гг. В параграфе 1 вводятся основные понятия теории множеств. В параграфах 2 и 3 излагаются элементы содержательного исчисления высказываний и предикатов. Содержательное исчисление предикатов представляет наибольшие трудности, этот раздел занимает в книге значительное место. Формальное исчисление высказываний и предикатов не затрагивается. В параграфах 4 и 5 логика предикатов применяется для построения начал алгебры подмножеств и теории бинарных отношений. В 6-ом на основе теории бинарных отношений излагаются начальные сведения по теории отображений и преобразований множеств.
Каждый параграф книги снабжен упражнениями. Часть из них содержит дополнительные теоретические сведения. В конце книги приведен краткий список литературы, по которой можно более подробно познакомиться с математической логикой и теорией множеств.
Какие данные можно получить о посетителе сайта при помощи php (браузер, ip, url и другое) или сервере (имя, почта и другое)?
Как расшифровываются переменные окружения в PHP (SERVER, REDIRECT и др) и что они передают?
DOCUMENT_ROOT - Путь к корневой папке сайта. Для локального веб-сервера значение может принимать вид z:/home/htmlbook.ru/www, а в других случаях зависит от операционной системы сервера и используемого программного обеспечения. GATEWAY_INTERFACE - Версия CGI (Common Gateway Interface, общий шлюзовый интерфейс). Значение обычно равно CGI/1.1. HTTP_ACCEPT - Типы файлов, которые способен принять браузер. В качестве значения возвращается список поддерживаемых MIME-типов разделенных между собой запятой, например: text/html, application/xhtml+xml. HTTP_CONNECTION - Тип соединения браузера с веб-сервером. Так, значение keep-alive означает, что браузер поддерживает постоянное соединение с сервером. При этом в течение одного сеанса соединения разрешено делать несколько запросов. Повторного соединения в таком случае уже не происходит. HTTP_HOST - Доменное имя сайта. Обычно различают имена с префиксом www (www.tradebenefit.ru) и без него (tradebenefit.ru). Переменная вернёт тот адрес сайта, который указан в адресной строке браузера. HTTP_REFERER - Адрес страницы, с которой пользователь перешел на данный сайт, он еще называется реферер. HTTP_USER_AGENT - Идентификатор используемого браузера и операционной системы. В качестве значения возвращается строка, содержащая ключевые слова. Например, следующая строка
говорит, что пользователь использует браузер Firefox 6.0.2 под операционной системой Windows 7.
QUERY_STRING - Запрос, который указан в адресной строке после вопросительного знака (?). Обычно пишется в форме «переменная=значение», где переменные разделяются между собой амперсантом. Рассмотрим пример.
REMOTE_ADDR - IP-адрес посетителя сайта. REQUEST_METHOD - Метод отправки данных на сервер. По умолчанию применяется метод GET. REQUEST_URI - Адрес запрашиваемого документа. Отсчёт ведётся от корня сайта, т.е. для полного адреса http://site.ru/1.html вернется значение 1.html. SERVER_ADDR - IP-адрес компьютера, на котором размещается сайт. SERVER_ADMIN - Адрес электронной почты администратора сайта. SERVER_NAME - Имя сервера. SERVER_PORT - Порт, по которому ожидается получение данных. SERVER_PROTOCOL - Протокол для получения и отправки данных. Значение обычно равно HTTP/1.1. SERVER_SOFTWARE - Программное обеспечение установленное на сервере. Для веб-сервера Apache возвращается номер версии (Apache/2.2.4), а также версия PHP (PHP/5.3.3).
Вторая часть серии статей "Использование регулярных выражений в PHP" посвящена решению ряда проблем обработки сложных текстов с помощью "продвинутых" операторов регулярных выражений.
Несмотря на то, что термины данные и информация используются взаимозаменяемо, между ними есть существенная разница. Данные существуют реально. Данные — - это список температур, перечень недавних продаж или опись товара, имеющегося в наличии. Информация — это прогнозы. Информация — это предсказание погоды, прогноз прибылей и убытков и тенденции сбыта. Данные записываются в виде нулей и единиц, в то время как информация обрабатывается мозгом.
Между данными и информацией располагается приложение: механизм, который преобразует одно в другое и наоборот. Например, при покупке книги в Интернете это приложение преобразует вашу информацию — название книги, идентификатор, информацию о банковском счете — в данные: номер заказа, цену со скидкой, характеристики транзакции с использованием кредитной карточки и количество оставшихся в наличии экземпляров книги. Аналогичным образом, приложение преобразует данные в запрос на выборку со склада, отметку об отгрузке и номер отслеживания — информацию, необходимую для реализации продажи.
В действительности сложность создания приложения прямо пропорциональна преобразованиям, которые оно выполняет. Гостевая книга Web-сайта, передающая имя и адрес в поля базы данных, устроена элементарно. С другой стороны, онлайновый магазин, который передает большое количество видов информации в модель данных коммерческой сделки и преобразует данные в информацию для реализации процесса принятия решений, достаточно сложен с точки зрения разработки. Искусство программирования заключается в умелом манипулировании данными и информацией — мастерство, схожее с фиксацией света в живописи.
Как было сказано в первой части, регулярные выражения являются одним из самых мощных средств манипулирования данными. Регулярные выражения лаконично описывают форму данных и раскладывают их на составляющие. Например, следующее регулярное выражение можно использовать для обработки температуры, заданной в градусах по Цельсию или по Фаренгейту: /^([+-]?[0-9]+)([CF])$/.
Регулярное выражение сравнивает начало строки (отображается знаком "крышка" (^), за которым идет знак "+", знак "-", или ничего ([+-]?), за которым следует целое число ([0-9]+), обозначение шкалы — Цельсия или Фаренгейта ([CF]) — и заканчивается концом строки (обозначается знаком доллара $).
В данном регулярном выражении операторы начала строки и конца строки представляют собой примеры операторов нулевой ширины или совпадений по положению, а не по символам. Круглые скобки также не указывают на символы. Зато, если заключить шаблон в круглые скобки, то будет извлечен текст, соответствующий шаблону. Следовательно, если текст полностью сопоставим с шаблоном, то первая пара круглых скобок выдаст строку, представляющую собой положительное или отрицательное целое число, например, +49, а вторая пара круглых скобок - или букву C, или F.
В первой части серии представлено понятие регулярного выражения и были описаны PHP-функции для сравнения текста с шаблонами, а также для извлечения совпадений. А теперь давайте углубимся в изучение регулярных выражений и посмотрим на некоторые "продвинутые" операторы и средства.
Круглые скобки опять приходят на помощь
В большинстве случаев пара круглых скобок используется для описания части шаблона и получения текста, соответствующего этой части. Однако от круглых скобок не всегда требуется получение части шаблона. Как и в сложной арифметической формуле, круглые скобки можно использовать для группировки условий.
Приведу пример. Догадаетесь, какому типу данных соответствует данное выражение?
/[-a-z0-9]+(?:\.[-a-z0-9]+)*\.(?:com|edu|info)/i
Как можно догадаться, это регулярное выражение определяет имена Интернет-сайтов (только для доменов .com, .edu, и .info). Отличием является использование дополнительного оператора ?:. Квалификатор части шаблона ?: отключает функцию извлечения данных, и тем самым дает круглым скобкам возможность обозначать последовательность действий. Например, в данном случае фраза (?:\.[-a-z0-9]+)* соответствует нулю или более элементам строки, например, ".ibm." Аналогично, фраза \.(?:com|edu|info) обозначает последовательность символов, за которой идет одна из строк com, edu, или info.
Отключение функции извлечения информации может показаться бессмысленным, если не подумать о том, что извлечение информации требует дополнительной обработки. Если программа обрабатывает большое количество данных, то отказ от извлечения может быть целесообразным. Кроме того, если вы имеете дело со сложным регулярным выражением, то отключение функции извлечения информации в некоторых частях шаблона может упростить извлечение тех частей шаблона, которые реально нужны.
Примечание: Модификатор i в конце регулярного выражения делает все сопоставления с шаблоном нечувствительными к регистру. Следовательно, подмножество a-z будет сопоставимо со всеми буквами, независимо от регистра.
В PHP есть и другие модификаторы частей шаблона (subpattern). Используя отладчик регулярных выражений, показанный в первой части данной серии (повторно показан в листинге 1), попробуйте сопоставить регулярное выражение ((?i)edu) со строками "EDU," "edu," и "Edu." Если в начале части шаблона задать модификатор (?i), то сопоставление с шаблоном не будет зависеть от регистра. Чувствительность к регистру восстанавливается, как только заканчивается данная часть шаблона. (Сравните с модификатором / ... /i, который применяется ко всему шаблону.)
Листинг 1. Простой отладчик регулярных выражений
Еще один полезный модификатор части шаблона - это (?x). Он позволяет добавлять в шаблон пробелы, что упрощает чтение регулярных выражений. Таким образом, часть шаблона ((?x) edu | com | info) (обратите внимание на пробелы между операторами дизъюнкции, которые добавлены для удобочитаемости) аналогична (edu|com|info). Для того, чтобы добавлять пробелы и комментарии в регулярное выражение, можно использовать глобальный модификатор / ... /x, см. листинг ниже.
Листинг 2. Добавление пробелов и комментариев
Как видно из листинга, при необходимости модификаторы можно объединять. Если необходимо включить в регулярное выражение символ пробела при использовании модификатора (?x), используйте метасимвол \s для поиска любого пробельного символа и \ (обратный слеш с пробелом) для поиска одного пробела, например, ((?x) hello \ there).
Оглядываемся вокруг
В подавляющем большинстве случаев регулярные выражения используются для проверки или декомпозиции входной информации на отдельные "лакомые кусочки", которые записываются в архив данных или сразу же обрабатываются приложением. Общепринятыми сферами применения являются: обработка полей форм, парсинг XML-кода и анализ протоколов.
Еще одна область применения регулярных выражений - форматирование, нормализация или улучшение читаемости данных. Вместо того чтобы использовать регулярные выражения для поиска и извлечения текста, при форматировании они применяются для поиска и вставки текста в надлежащее местоположение.
Вот пример полезного применения форматирования. Предположим, что Web-форма передает приложению значение зарплаты с округлением до целого доллара. Так как зарплата хранится в виде числа целого типа, то перед сохранением переданных данных приложение должно удалять из них знаки пунктуации. Однако при извлечении данных из хранилища, возможно, понадобится изменить их формат и сделать удобочитаемыми с помощью разделителей. В листинге 3 показано, как простой PHP-запрос преобразует сумму в долларах в число.
Листинг 3. Преобразование суммы в долларах в число
Вызов функции preg_replace() заменяет знак доллара, любой пробельный символ и все запятые -- на пустую строку, возвращая то, что предположительно является целым числом. Если проверка функцией is_numeric() подтверждает правильность входных данных, их можно сохранить.
А теперь давайте выполним обратную операцию - добавим к числу знак денежной единицы и запятые-разделители сотен, тысяч и миллионов. Для добавления запятых в определенных позициях можно написать программу для поиска этих компонентов, а можно воспользоваться операторами посмотри вперед и посмотри назад. Модификатор части шаблона ?<= обозначает посмотри назад (то есть влево) от текущей позиции. Модификатор ?= означает "посмотри вперед" (то есть вправо) от текущей позиции.
[pagebreak]
Итак, какие позиции нам нужны? Любое место в строке, при условии, что есть как минимум один символ слева и одна или более групп по три символа справа, не считая десятичной точки и количества центов. Соблюдая это правило и используя два модификатора, анализирующих символы справа и слева от определенной позиции и являющихся операторами нулевой ширины, мы можем достичь цели с помощью следующей инструкции:
Как работает это регулярное выражение? Начиная с первого символа строки и обрабатывая каждый символ, регулярное выражение отвечает на вопрос: "Есть ли хотя бы один символ слева и одна или несколько групп из трех символов справа?" Если да, то наш оператор нулевой ширины заменяется запятой.
Большинство сложных сопоставлений можно реализовать, используя стратегию, аналогичную приведенной выше. Например, вот еще один вариант использования оператора "посмотри вперед", который решает широко распространенную дилемму.
Листинг 4. Пример использования оператора "посмотри вперед" ("предвидение")
Оператор preg_replace() преобразует строку данных, разделенных запятыми, в строку данных, разделенных знаком табуляции. Предусмотрительным образом, он не заменяет запятые в строке, заключенной в кавычки.
Это регулярное выражение при каждом обнаружении запятой (на это указывает запятая в самом начале регулярного выражения) проверяет утверждение: "Впереди не было кавычек или было четное количество кавычек". Если утверждение верно, то запятую можно заменить знаком табуляции (the \t).
Если Вам не нравятся операторы «посмотри вперед» и «посмотри назад» или вы работаете с таким языком, в котором их нет, можно добавить запятые в число и с помощью обычного регулярного выражения. Однако для реализации такого решения потребуется много итераций.
Листинг 5. Добавление запятых
Давайте пройдем по коду. Сначала параметр зарплаты очищается от знаков пунктуации для моделирования ситуации чтения целого числа из базы данных. Затем выполняется цикл в поисках позиций, где за одним числовым символом ((\d) идут три числовых символа ((\d\d\d\): если обнаруживается граница слова, заданная как \b, цикл прекращается. Граница слова -- это еще один оператор нулевой ширины, который соответствует следующим позициям:
* Перед первым символом строки, если это буква слова.
* За последним символом строки, если это буква слова.
* Между буквой слова и небуквенным символом, непосредственно за буквой слова.
* Между небуквенным символом и буквой слова, непосредственно за небуквенным символом.
Таким образом, примерами правильных границ слова являются пробел, точка и запятая.
Благодаря внешнему циклу регулярное выражение перемещается слева направо в поисках цифры, за которой идут три цифры и граница слова. При обнаружении совпадения между двумя частями шаблона добавляется запятая. Цикл должен продолжаться до тех пор, пока оператор preg_replace() находит совпадения, что задано в условии $old != $pretty_print.
Жадность и лень
Регулярные выражения обладают большими возможностями, иногда даже слишком большими. Например, давайте рассмотрим, что произойдет, если регулярное выражение ".*" будет обрабатывать строку "The author of 'Wicked' also wrote 'Mirror, Mirror.'" Вероятно, вы предполагаете, что preg_match() вернет два совпадения, и с удивлением обнаружите, что результат всего один: 'Wicked' also wrote 'Mirror, Mirror.'
Почему? Если не задать иное, то такие операторы как * (ноль или более) и + (один или более) -- "жадные". Если сопоставление с образцом может продолжаться, то они и будут его продолжать до тех пор, пока не будет возвращен максимальный результат из возможных. Для сохранения минимальных совпадений необходимо принудительно заставлять определенные операторы быть "ленивыми". "Ленивые" операторы находят самое короткое совпадение и на этом останавливаются. Чтобы сделать оператор более "ленивым", добавьте суффикс в виде знака вопроса. Пример показан в листинге 6.
Листинг 6. Добавление суффикса в виде знака вопроса
Регулярное выражение ".*?" расшифровывается следующим образом: "найти кавычку, за которой идет ровно столько символов с последующей кавычкой.
Однако иногда оператор * может быть слишком "ленивым". Например, посмотрите на следующий фрагмент кода. Что он делает?
Листинг 7. Простой отладчик регулярных выражений
Что вы загадали? "123"? "1"? Нет результата? На самом деле результатом будет Array ( [0] => [1] => ), означающий, что совпадение было найдено, но никаких данных извлечено не было. Почему? Вспомните, что оператор * ищет совпадения с нулем или более символов. В данном случае, выражение [0-9]* находит совпадение с нулем символов от начала строки, и обработка заканчиваетс.
Для решения данной проблемы добавьте оператор нулевой ширины для привязки совпадения, который заставляет регулярное выражение продолжать сопоставления; /([0-9]*\b/.
Советы и рекомендации
С помощью регулярных выражений можно решать как простые, так и сложные задачи при обработке текста. Начните с небольшой группы операторов и по мере того, как вы будете набираться опыта, расширяйте свой словарь. В качестве вознаграждения за ваши старания -- некоторые советы и рекомендации.
Создание переносимых регулярных выражений с помощью классов символов
Вам уже знакомы метасимволы, например, \s - соответствует любому пробельному символу. Кроме того, большинство реализаций регулярных выражений поддерживает предопределенные классы символов, которые более просты в использовании и переносимы с одного письменного языка на другой. Например, класс символов [:punct:] замещает все символы пунктуации в данном языке. Вместо [0-9] можно использовать [:digit:] и более переносимое замещение [:alpha:] вместо [-a-zA-Z0-9_]. Например, можно убрать все знаки пунктуации, используя:
Класс символов представляет собой более сжатую форму по сравнению с подробным описанием всех символов пунктуации. Полный перечень классов символов можно найти в документации по версии языка PHP.
Как исключить то, что вы не ищете
Как показано в примере с данными, разделенными символом табуляции, в качестве значений, разделенных запятыми (CSV), иногда проще и точнее задать список тех вариантов, которые не нужно находить (сопоставлять). Последовательность, начинающаяся со знака "крышка" (^) будет соответствовать любому символу, не принадлежащему данной последовательности. Например, для проверки правильности телефонных номеров для США можно использовать регулярное выражение /[2-9][0-9]{2}[2-9][0-9]{2}[0-9]{4}/. Используя набор ограничений можно написать регулярное выражение в более явном виде /[^01][0-9]{2}[^01][0-9]{2}[0-9]{4}/. Оба регулярных выражения работают, хотя смысл последнего, вероятно, более понятен.
Пропуск новой строки
Если во входных данных несколько строк, стандартного регулярного выражения будет недостаточно, так как сканирование прекращается на начале новой строки, которая обозначается $. Однако, если воспользоваться модификаторами s или m, то регулярное выражение будет обрабатывать входные данные по-другому. Первый модификатор рассматривает строковую последовательность как одну строку, где точка указывает на начало новой строки (обычно она этого не делает). Второй рассматривает строковую последовательность как несколько строк, где ^ и $ соответствуют началу и концу любой строки, соответственно. Приведем пример. Если задать $string = "Hello,\nthere";, то оператор preg_match( "/.*/s", $string, $matches) параметру $matches[0] присвоит значение Hello,\nthere. (При удалении s будет выдано Hello.)
dBASE и Paradox таблицы имеют в своем арсенале BLOB-поля, позволяющие хранить бинарные данные, в том числе bitmap-формат, отображаемый с помощью компонента TDBImage. В Database Desktop данный тип полей указан как Binary и Graphic (для dBASE и Paradox таблиц, соответственно). Тем не менее, процесс сохранения изображений в InterBase BLOB-полях и их использование в компонентах TDBImage не такой уж простой.
Таблицы InterBase не имеют простого типа BLOB-поля. Есть три варианта, или подтипа: тип 0, тип 1 и подтип, определенный пользователем. Типы 0 и 1 - "встроенные" типы. Тип 0 - BLOB-поля (тип по умолчанию) для хранения общих бинарных данных. Тип 1 - BLOB-поля для хранения текстовых BLOB-данных. Ни один из предопределенных типов не допускает автоматического извлечения данных изображения из BLOB-поля для его последующего отображения в компоненте TDBImage. BLOB-поля типа 0 могут использоваться для хранения данных bitmap-формата, но данные должны извлекаться и передаваться в объект типа TBitmap программным путем. Вот пример ручного извлечения данных изображения, хранящихся в BLOB-поле типа 0 (Table1BLOBField), и его показ в компоненте TImage (не предназначенным для работы с БД) :
Естественно, поскольку это должно делаться вручную, данный процесс менее желателен в приложении, нежели автоматическое отображение данных изображения в комбинации BDE и компонента TDBImage. Здесь происходит определение подтипа определенного пользователем BLOB-поля. При работе с данными подтип BLOB-поля учитывается, т.к. сохраненные первыми данные устанавливают тип данных для этого поля для всей таблицы целиком. Таким образом, если данные bitmap-формата оказывается первым загружаемым типом, то данный формат будет единственно возможным для данного поля. До сих пор по умолчанию тип бинарного BLOB-поля (предопределенный тип 0) позволял BDE читать и отображать данные в компоненте TDBImage без особых проблем.
Утилиты Database Desktop допускают создание бинарных BLOB-полей только типа 0 и не имеют возможности самим определять подтипы BLOB-полей. Из-за такого ограничения таблицы, подразумевающие хранение и вывод изображений, должны создаваться с помощью SQL-запросов. Обычно это делается посредством утилиты WISQL, но вполне достаточно выполнение SQL-запроса с помощью компонента TQuery. Ниже приведен SQL-запрос, создающий таблицу с определенным пользователем подтипом BLOB-поля:
После создания таблицы с совместимыми BLOB-полями, для хранения данных изображения в BLOB-поле и его вывода в компоненте TDBImage используются те же самые методы, что и при работе с таблицами dBASE и Paradox.
Имеется множество способов загрузки изображений в BLOB-поле. Три самых простых метода включают в себя:
копирование данных из буфера обмена Windows в компонент TDBImage, связанный с BLOB-полем
использование метода LoadFromFile компонента TBLOBField
использование метода Assign для копирования объекта типа TBitmap в значение свойства Picture компонента TBDBImage.
Первый способ, когда происходит копирование изображения из буфера обмена, вероятно, наиболее удобен в случае, когда необходимо добавить изображение в таблицу при использовании приложения конечным пользователем. В этом случае компонент TDBImage используется в роли интерфейса между BLOB-полем таблицы и изображением, хранящимся в буфере обмена. Метод PasteFromClipboard компонента TDBImage как раз и занимается тем, что копирует изображение из буфера обмена в TDBImage. При сохранении записи изображение записывается в BLOB-поле таблицы.
Поскольку буфер обмена Windows может содержать данные различных форматов, то желательно перед вызовом метода CopyFromClipboard осуществлять проверку формата хранящихся в нем данных. Для этого необходимо создать объект TClipboard и использовать его метод HasFormat, позволяющий определить формат хранящихся в буфере данных. Имейте в виду, что для создания объекта TClipboard вам необходимо добавить модуль Clipbrd в секцию uses того модуля, в котором будет создаваться экземпляр объекта.
Вот исходный код примера, копирующий содержание буфера обмена в компонент TDBImage, если содержащиеся в буфере данные имеют формат изображения:
Второй способ заполнения BLOB-поля заключается в загрузке изображения непосредственно из файла в BLOB-поле. Данный способ одинаково хорош как при создании приложения (формирование данных), так и при его использовании.
Этот способ использует метод LoadFromFile компонента TBLOBField, который применяется в Delphi для работы с dBASE-таблицами и двоичными Windows полями или таблицами Paradox и графическими Windows полями; в обоих случаях с помощью данного метода возможно загрузить изображение и сохранить его в таблице.
Методу LoadFromFile компонента TBLOBField необходим единственный параметр типа String: имя загружаемого файла с изображением. Значение данного параметра может быть получено при выборе файла пользователем с помощью компонента TOpenDialog и его свойства FileName.
Вот пример, демонстрирующий работу метода LoadFromFile компонента TBLOBField с именем Table1Bitmap (поле с именем Bitmap связано с таблицей TTable, имеющей имя Table1):
Третий способ для копирования содержимого объекта типа TBitmap в свойство Picture компонента TDBImage использует метод Assign. Объект типа TBitmap может быть как свойством Bitmap свойства-объекта Picture компонента TImage, так и отдельного объекта TBitmap. Как и в методе, копирующем данные из буфера обмена в компонент TDBImage, данные изображения компонента TDBImage сохраняются в BLOB-поле после успешного сохранения записи.
Ниже приведен пример, использующий метод Assign. В нашем случае используется отдельный объект TBitmap. Для помещения изображения в компонент TBitmap был вызван его метод LoadFromFile.
Часто работая в Фотошоп, приходится выполнять целый ряд постоянно повторяющихся операций. Такие операции выстраиваясь определенным образом, образуют цепочку команд - макропоследовательностей. Чтобы не повторять последовательность одних и тех же команд снова и снова, можно задействовать инструменты автоматизации. Одним из таких инструментов является Actions.
Автоматизация работы в Photoshop.
Часто работая в Фотошоп, приходится выполнять целый ряд постоянно повторяющихся операций. Такие операции выстраиваясь определенным образом, образуют цепочку команд - макропоследовательностей. Чтобы не повторять последовательность одних и тех же команд снова и снова, можно задействовать инструменты автоматизации. Одним из таких инструментов является Actions. Action - это записанный набор команд, которые можно быстро повторить. За такими макропоследовательностями также можно закреплять клавиатурные сокращения, то есть для их выполнения достаточно нажать клавишу или сочетание клавиш.
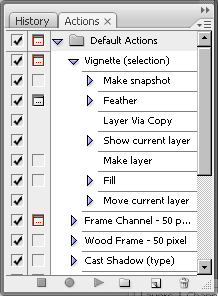
Для работы с Actions используется одноименная палитра. Чтобы увидеть эту палитру, следует выполнить команду Window>Actions или нажать клавишу F9.
Стандартные Actions
По умолчанию в Photoshop уже есть стандартный набор записанных команд, поэтому списки последовательно выполняющихся команд можно создавать самостоятельно, а можно воспользоваться уже готовыми. Например, используя стандартный макрос для создания виньетки (Vignette), достаточно выделить область на изображении и нажать кнопку его запуска.
Таким образом, все макропоследовательности состоят из команд, которые являются последними ступеньками в раскрывающемся списке.
Для удобства работы, макропоследовательности объединяются в наборы - Sets. Например, можно создать набор, в котором будут собраны макросы для работы с текстом, для создания различных текстур и т.д. По умолчанию в Photoshop есть набор Default Actions.
Палитра Actions содержит наборы различных последовательностей. Чтобы их увидеть, необходимо щелкнуть на треугольнике, расположенном слева от названия набора. После этого перед вами появится список действий, любое из которых может быть выполнено. Если вы хотите увидеть, из каких операций состоят действия, то следует щелкнуть на треугольнике, расположенном слева от них.
Внизу палитры расположены кнопки, позволяющие управлять действиями - создавать новые, запускать и останавливать запись и т.д.
Просмотрите все предлагаемые Actions на изображении с небольшим разрешением (на нем макрокоманды будут выполняться быстрее). После такого просмотра можно сформировать свою палитру, оставив понравившиеся элементы и удалив те, которые вам никогда не пригодятся. Можно также изменить названия, чтобы стало понятнее, где какая возможность скрывается.
Если какое-нибудь действие вам очень понравилось, то посмотрите, как оно было сделано. Для этого следует обратиться к палитре Actions и, раскрыв все списки, просмотреть последовательность выполняемых операций.
Лучше всего не только просмотреть, как выполнялись операции, но и попытаться добиться такого же эффекта, проделав самостоятельно все действия, особенно если вы неопытный пользователь. Это поможет лучше узнать программу, а также ознакомиться с возможностями, которые она предоставляет. Кроме того, в процессе работы можно будет изменить некоторые параметры, подобрав их для конкретного изображения.
Создание собственных макрокоманд
Можно не только пользоваться готовыми макрокомандами, но и создавать свои собственные.
Приведем пример ситуации, в которой они могу оказаться полезными. Предположим, вы хотите выложить фотографии в интернете. Прежде чем публиковать их в сети, нужно выполнить цветокоррекцию и уменьшить размер. Допустим, вы решили делать цветокоррекцию в режиме Lab Color.
Рассмотрим список действий, которые необходимо выполнить с каждым изображением:
1) Выполнить команду Image>Mode>Lab Color, чтобы перевести снимок в цветовое пространство Lab Color.
2) Повысить четкость изображения, для чего нужно перейти на палитру Channels, выделить канал Lightness и применить к нему фильтр Sharpen>Unsharp Mask. Благодаря тому, что фильтр применяется в канале освещенности, можно повысить резкость изображения, не затрагивая цветовую составляющую.
3) Улучшить цвета на изображении, для чего нужно выделить цветовой канал b, вызвать окно редактирования кривых, выполнив команду Image>Adjustments>Curves или же используя сочетание клавиш CTRL+M, и изменить форму кривой. Чем круче график кривой, тем более контрастным становится изображение в канале, и тем более насыщенными становятся цвета на снимке.
4) Выделить цветовой канал a и проделать те же действия с изменением формы кривой.
5) Наконец, нужно изменить размер изображения, используя команду Image>Image Size.
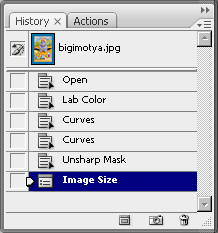
Если после этого отобразить палитру History, можно увидеть, что пришлось выполнить целый ряд команд и действий, чтобы обработать фотографию. Эти действия нужно было бы повторять с каждой следующей фотографией, которую вы хотите выложить в интернете.
Задачу можно существенно упростить, используя Actions. Вернемся к исходному изображению, используя палитру History, и создадим собственный макрос. Сначала создадим новую группу для хранения макросов. Для этого нужно нажать кнопку Create New Set в нижней части палитры Actions.
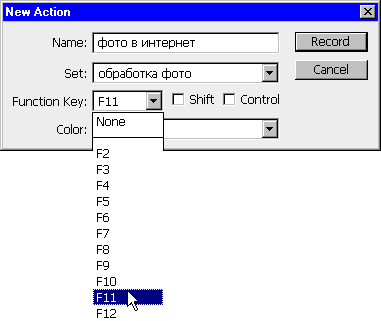
В окне New Set введим название набора команд. Создадим в новой группе первый макрос, нажав кнопку Create New Action. В появившемся окне New Action выберем название макроса и клавишу, при нажатии которой он будет запускаться, например, F11. Для вызова макропоследовательностей можно использовать клавиши F2-F12, а также их сочетания с клавишами CTRL и Shift.
Для начала записи необходимо нажать кнопку Record в нижней части палитры Actions. Теперь любая команда, выполненная в Photoshop, будет запоминаться до тех пор, пока вы не остановите запись макроса.
Скроем палитру Actions, чтобы она не мешала, и повторим выполненные ранее действия: переведем изображение в Lab Color, увеличим резкость, изменим цветопередачу и уменьшим размер изображения при помощи команды Image Size.
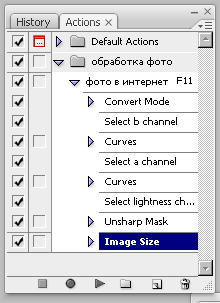
После этого вернемся на палитру Actions и остановим запись, нажав кнопку Stop Playing/Recording. В списке нашего макроса можно увидеть записанную последовательность команд. Также рядом с названием макроса отображается горячая клавиша, которая выбрана для его запуска.
Чтобы проверить действие макроса, вернемся к исходному изображению, используя палитру History, и нажмем горячую клавишу, которую вы выбрали для выполнения макроса. Можно убедиться, что все действия выполняются автоматически и довольно быстро. Макрос также можно запускать, нажимая кнопку Play Selecтion в нижней части палитры Actions, если предварительно выделить его в списке макрокоманд.
Записав макрос, посмотрите, как макрокоманда сработает на другой фотографии. Откройте изображение в Photoshop и снова запустите макрос горячей клавишей. Как вы можете убедиться, макрос работает.
Таким образом, благодаря макросам на подготовку фотографий для публикации в интернете может уходить гораздо меньше времени. Достаточно нажать горячую клавишу - и можно сохранять изображение.
Сохранение макрокоманд
В ряде случаев, например, при переустановке системы или при необходимости использовать созданные ранее макросы на другом компьютере, возникает необходимость сохранить Actions. Такая возможность предусмотрена в Photoshop.
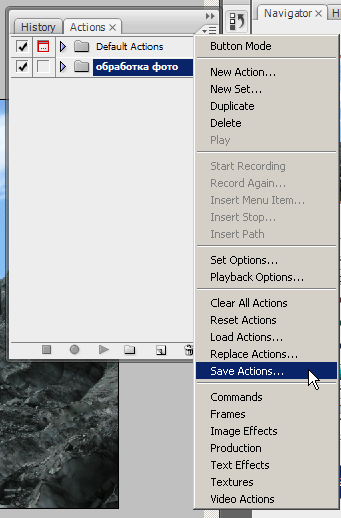
Actions нельзя сохранять по отдельности, только в наборах. Поэтому для сохранения макропоследовательностей выделите на палитре Actions тот набор, в который они входят, после чего нажмите миниатюрную кнопку, расположенную в верхней правой части палитры (под кнопкой для сворачивания палитры) и выберите команду Save Actions. Если при этом будет выделен не набор, а отдельный макрос, эта команда будет неактивна.
Наборы макросов сохраняются в файлы с расширением ATN. Для загрузки сохраненного ранее набора в Photoshop необходимо щелкнуть по той же кнопке на палитре Actions и выбрать команду Load Actions.
Инструмент Batch
В Photoshop есть еще одно средство для автоматизации, которое удобно использовать вместе с Actions. Это - инструмент пакетной обработки Batch. С его помощью можно применить макропоследовательность к группе файлов, даже не открывая их в Photoshop.
Приведем простой пример использования этого инструмента. Предположим, необходимо перед публикацией фотографий в интернете защитить свое авторское право. Для этого можно добавить на фотографии какой-нибудь текст, например, адрес сайта.
Для начала запишем в макрос все действия, которые необходимо выполнить. Создадим новый Action и начнем запись. Макрос будет состоять из трех действий: добавление на изображение текста, сохранение изображения в формате JPEG и закрытие исходного файла. После выполнения этих операций остановим запись макроса.
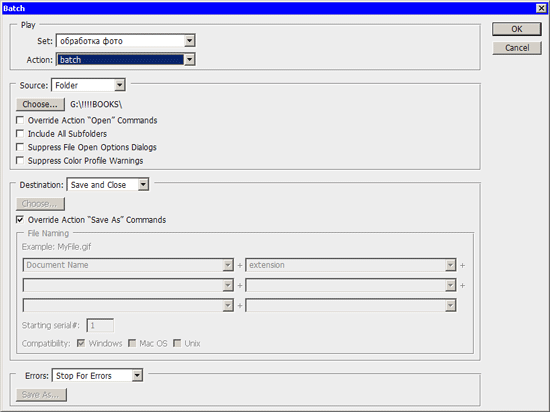
Выполним команду File>Automate>Batch. В окне Batch необходимо установить настройки пакетной обработки файлов. В разделе Play выбирается группа, в которую сохранен макрос и его название.
В разделе Source необходимо указать путь к папке, содержащей исходные файлы. Если установить флажок Include All Subfolders, то будут обработаны и файлы, которые находятся во вложенных папках.
В разделе Destination устанавливаются параметры сохранения файлов. Если выбрать в этом списке вариант None, то файлы не будут сохраняться автоматически. Вместо этого Photoshop будет выдавать запрос на сохранение каждого файла. При выборе варианта Save and close файлы будут сохранены в ту же папку, где хранятся исходные изображения.
Для того чтобы файлы были автоматически сохранены, нужно выбрать в списке Destination вариант Save and close. При выборе варианта Folder появляется возможность указать папку для сохранения обработанных файлов. Кроме этого, можно переименовать их, используя маску. Название файла может включать исходное имя, представленное строчными или заглавными буквами, дату выполнения операции в разных форматах, порядковый номер, букву алфавита, расширение.
Флажок Override Action Save As Commands нужно использовать осторожно. Если он установлен, то файлы будут сохранены только в том случае, если операция сохранения является одним из шагов макроса.
Для запуска пакетной обработки необходимо закрыть окно Batch, нажав кнопку OK. После этого файлы будут один за другим открываться в Photoshop, к ним будут применяться заданные операции, после чего они будут закрываться и сохраняться.
Batch и Actions - это очень полезные инструменты Photoshop, которые могут сэкономить не один час времени. Кроме этого, Actions могут стать хорошим пособием для изучения программы - загрузите в Photoshop наборы макропоследовательностей, созданные опытными пользователями, и пошагово разберите, как они работают.
Сеть всегда объединяет несколько абонентов, каждый из которых имеет право передавать свои пакеты. Но, как уже отмечалось, по одному кабелю одновременно передавать два (или более) пакета нельзя, иначе может возникнуть конфликт (коллизия), который приведет к искажению либо потере обоих пакетов (или всех пакетов, участвующих в конфликте). Значит, надо каким-то образом установить очередность доступа к сети (захвата сети) всеми абонентами, желающими передавать. Это относится, прежде всего, к сетям с топологиями шина и кольцо. Точно так же при топологии звезда необходимо установить очередность передачи пакетов периферийными абонентами, иначе центральный абонент просто не сможет справиться с их обработкой.
В сети обязательно применяется тот или иной метод управления обменом (метод доступа, метод арбитража), разрешающий или предотвращающий конфликты между абонентами. От эффективности работы выбранного метода управления обменом зависит очень многое: скорость обмена информацией между компьютерами, нагрузочная способность сети (способность работать с различными интенсивностями обмена), время реакции сети на внешние события и т.д. Метод управления – это один из важнейших параметров сети.
Тип метода управления обменом во многом определяется особенностями топологии сети. Но в то же время он не привязан жестко к топологии, как нередко принято считать.
Методы управления обменом в локальных сетях делятся на две группы:
* Централизованные методы, в которых все управление обменом сосредоточено в одном месте. Недостатки таких методов: неустойчивость к отказам центра, малая гибкость управления (центр обычно не может оперативно реагировать на все события в сети). Достоинство централизованных методов – отсутствие конфликтов, так как центр всегда предоставляет право на передачу только одному абоненту, и ему не с кем конфликтовать.
* Децентрализованные методы, в которых отсутствует центр управления. Всеми вопросами управления, в том числе предотвращением, обнаружением и разрешением конфликтов, занимаются все абоненты сети. Главные достоинства децентрализованных методов: высокая устойчивость к отказам и большая гибкость. Однако в данном случае возможны конфликты, которые надо разрешать.
Существует и другое деление методов управления обменом, относящееся, главным образом, к децентрализованным методам:
* Детерминированные методы определяют четкие правила, по которым чередуются захватывающие сеть абоненты. Абоненты имеют определенную систему приоритетов, причем приоритеты эти различны для всех абонентов. При этом, как правило, конфликты полностью исключены (или маловероятны), но некоторые абоненты могут дожидаться своей очереди на передачу слишком долго. К детерминированным методам относится, например, маркерный доступ (сети Token-Ring, FDDI), при котором право передачи передается по эстафете от абонента к абоненту.
* Случайные методы подразумевают случайное чередование передающих абонентов. При этом возможность конфликтов подразумевается, но предлагаются способы их разрешения. Случайные методы значительно хуже (по сравнению с детерминированными) работают при больших информационных потоках в сети (при большом трафике сети) и не гарантируют абоненту величину времени доступа. В то же время они обычно более устойчивы к отказам сетевого оборудования и более эффективно используют сеть при малой интенсивности обмена. Пример случайного метода – CSMA/CD (сеть Ethernet).
Для трех основных топологий характерны три наиболее типичных метода управления обменом.
Управление обменом в сети с топологией звезда
Для топологии звезда лучше всего подходит централизованный метод управления. Это связано с тем, что все информационные потоки проходят через центр, и именно этому центру логично доверить управление обменом в сети. Причем не так важно, что находится в центре звезды: компьютер (центральный абонент), как на рис. 1.6, или же специальный концентратор, управляющий обменом, но сам не участвующий в нем. В данном случае речь идет уже не о пассивной звезде (рис. 1.11), а о некой промежуточной ситуации, когда центр не является полноценным абонентом, но управляет обменом. Это, к примеру, реализовано в сети 100VG-AnyLAN.
Самый простейший централизованный метод состоит в следующем.
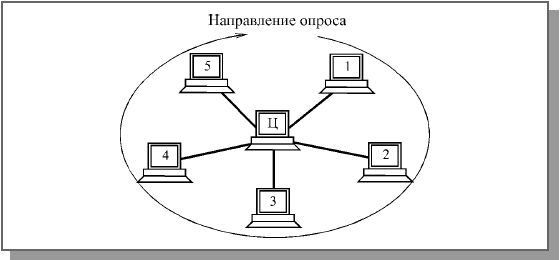
Периферийные абоненты, желающие передать свой пакет (или, как еще говорят, имеющие заявки на передачу), посылают центру свои запросы (управляющие пакеты или специальные сигналы). Центр же предоставляет им право передачи пакета в порядке очередности, например, по их физическому расположению в звезде по часовой стрелке. После окончания передачи пакета каким-то абонентом право передавать получит следующий по порядку (по часовой стрелке) абонент, имеющий заявку на передачу (рис. 4.8). Например, если передает второй абонент, то после него имеет право на передачу третий. Если же третьему абоненту не надо передавать, то право на передачу переходит к четвертому и т.д.
Централизованный метод управления обменом в сети с топологией звезда
Рис. 4.8. Централизованный метод управления обменом в сети с топологией звезда
В этом случае говорят, что абоненты имеют географические приоритеты (по их физическому расположению). В каждый конкретный момент наивысшим приоритетом обладает следующий по порядку абонент, но в пределах полного цикла опроса ни один из абонентов не имеет никаких преимуществ перед другими. Никому не придется ждать своей очереди слишком долго. Максимальная величина времени доступа для любого абонента в этом случае будет равна суммарному времени передачи пакетов всех абонентов сети кроме данного. Для топологии, показанной на рис. 4.8, она составит четыре длительности пакета. Никаких столкновений пакетов при этом методе в принципе быть не может, так как все решения о доступе принимаются в одном месте.
Рассмотренный метод управления можно назвать методом с пассивным центром, так как центр пассивно прослушивает всех абонентов. Возможен и другой принцип реализации централизованного управления (его можно назвать методом с активным центром).
В этом случае центр посылает запросы о готовности передавать (управляющие пакеты или специальные сигналы) по очереди всем периферийным абонентам. Тот периферийный абонент, который хочет передавать (первый из опрошенных) посылает ответ (или же сразу начинает свою передачу). В дальнейшем центр проводит сеанс обмена именно с ним. После окончания этого сеанса центральный абонент продолжает опрос периферийных абонентов по кругу (как на рис. 4.8). Если желает передавать центральный абонент, он передает вне очереди.
Как в первом, так и во втором случае никаких конфликтов быть не может (решение принимает единый центр, которому не с кем конфликтовать). Если все абоненты активны, и заявки на передачу поступают интенсивно, то все они будут передавать строго по очереди. Но центр должен быть исключительно надежен, иначе будет парализован весь обмен. Механизм управления не слишком гибок, так как центр работает по жестко заданному алгоритму. К тому же скорость управления невысока. Ведь даже в случае, когда передает только один абонент, ему все равно приходится ждать после каждого переданного пакета, пока центр опросит всех остальных абонентов.
Как правило, централизованные методы управления применяются в небольших сетях (с числом абонентов не более чем несколько десятков). В случае больших сетей нагрузка по управлению обменом на центр существенно возрастает.
Управление обменом в сети с топологией шина
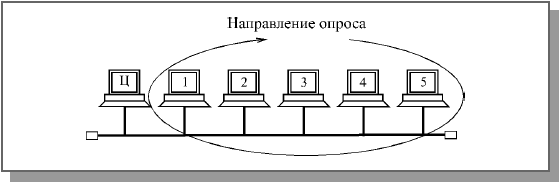
При топологии шина также возможно централизованное управление. При этом один из абонентов ("центральный") посылает по шине всем остальным ("периферийным") запросы (управляющие пакеты), выясняя, кто из них хочет передать, затем разрешает передачу одному из абонентов. Абонент, получивший право на передачу, по той же шине передает свой информационный пакет тому абоненту, которому хочет. А после окончания передачи передававший абонент все по той же шине сообщает "центру", что он закончил передачу (управляющим пакетом), и "центр" снова начинает опрос (рис. 4.9).
Централизованное управление в сети с топологией шина
Рис. 4.9. Централизованное управление в сети с топологией шина
Преимущества и недостатки такого управления – те же самые, что и в случае централизованно управляемой звезды. Единственное отличие состоит в том, что центр здесь не пересылает информацию от одного абонента к другому, как в топологии активная звезда, а только управляет обменом.
Гораздо чаще в шине используется децентрализованное случайное управление, так как сетевые адаптеры всех абонентов в данном случае одинаковы, и именно этот метод наиболее органично подходит шине. При выборе децентрализованного управления все абоненты имеют равные права доступа к сети, то есть особенности топологии совпадают с особенностями метода управления. Решение о том, когда можно передавать свой пакет, принимается каждым абонентом на месте, исходя только из анализа состояния сети. В данном случае возникает конкуренция между абонентами за захват сети, и, следовательно, возможны конфликты между ними и искажения передаваемой информации из-






 Поиск