"Профессиональное руководство по SQL Server: хранимые процедуры, XML, HTML."
Книга посвящена философии программирования в Transact-SQL. Она объясняет, как применять эту философию для создания собственных способов кодирования и решения повседневных проблем. В ней помимо основной темы — хранимых процедур — раскрыто множество вспомогательных, среди которых XML, HTML, .NET. Причина этого проста: когда вы создаете реальное программное обеспечение, вам всегда приходится работать с несколькими технологиями. Эта книга признает данный факт, раскрывая многие сопутствующие технологии и рассматривая их с точки зрения разработки хранимых процедур для SQL-сервера. Книга рассчитана на разработчиков среднего и высокого уровня, которые хотят совершенствоваться в программировании хранимых процедур.
Многие мои друзья и знакомые часто спрашивают меня о том, как устроен мой сайт, сколько у меня таблиц в базе данных, как я храню данные и по каким полям веду поиск. Я, конечно, не выдаю все свои государственные тайны, но всегда понимаю причину таких вопросов и пытаюсь помочь людям построить быструю и надежную базу данных - т.е. тщательно продумать структуру БД таким образом, чтобы при увеличении нагрузки или объема таблиц динамический веб-сайт не превратился в тормозное усмертие.
А ведь многие новички (веб-строители) даже не догадываются о том, что крупные динамические сайты тормозят вовсе не из-за нагрузки скриптов на процессор, а в основном из-за неоптимизированного или дохленького MySQL-сервера. При этом во многом все зависит от того, как устроена ваша база данных.
Итак, начнем ликбез. Сразу всем вопрос: что делает MySQL во время записи в таблицы типа INSERT или UPDATE? Правильно - БЛОКИРУЕТ ТАБЛИЦЫ и пишет в них данные. Скорость записи и поиска может быть достаточно низкой, поэтому статус таблиц запрещает другим процессам считывать из них данные до окончания операции записи или обновления и снятия блокировки. При этом может получиться так, что во время записи единственного поля в длинные таблицы, ваш MySQL-сервер надолго заблокирует доступ к таблице остальным скриптам.
Например, вы создали таблицу новостей такого типа:
ID - номер, первичный ключ TEMA - тема новости MESS - сообщение, сама новость VIEWS - количество просмотров
При каждом обращении к новостям, скрипт будет выводить саму новость, а потом увеличивать поле VIEWS запросом UPDATE table 'NEWS' set VIEWS=VIEWS+1 where id=ID. При этом количество апдейтов будет довольно высоким. При высокой посещаемости веб-ресурса или при "нападении" на сайт поискового робота (эти ребята страдают многопоточностью и могут запросто повесить ваш сайт своими запросами) несколько одновременных процессов станут пытаться сделать UPDATE и SELECT. При каждом UPDATE таблица будет блокироваться (на это уходит время) и все остальные процессы будут ждать завершения операции. А если таблица достаточно большая? Например, несколько тысяч записей. Ежу понятно, что построится очередь из нескольких десятков скриптов, ожидающих ответа MySQL-сервера. Каждый будет жрать память и держать остальные процессы. В итоге все у вас зависнет и переглючит. Выход: делать вместо одной таблицы несколько. Советую разделять поля по типу их использования. Одну таблицу - только для вывода и редких обновлений или вставок. Другую - для частых обновлений, но редкого вывода. Например, значения счетчика обращений держать отдельно в таблицу вида:
ID - номер, первичный ключ VIEWS - количество просмотров
Сами новости лучше держать в другой таблице, где нет поля VIEWS. При этом таблица с новостями будет тяжелой (много текста, полей, индексов), а таблица COUNT (счетчик) будет очень легкой и быстрой. Таблица NEWS будет кешироваться и выводиться очень быстро при любых объемах, а таблица COUNT будет быстро обновляться из-за того, что она очень легкая (всего два целочисленных поля). Разделение данных по нескольким таблицам существенно ускоряет работу MySQL-сервера. Гораздо быстрее работают несколько мелких запросов по каждой таблице, чем один длинный запрос по одной или нескольким таблицам. Имейте это в виду, чтобы спать спокойно.
Дальше - круче. Чтобы не блокировать лишний раз свои таблицы используйте при вставках директиву DELAYED. Пример: INSERT DELAYED into STAT (ID,IP,UTIME) values (null,$ip,NOW()). Он позволяет серверу ответвлять поток в режиме ожидания, а саму вставку производить тогда, когда сервер освободится от других запросов или поступит следующий аналогичный INSERT DELAYED. Обычно отложенный метод подходит для любых операций с кумулятивными таблицами (когда в основном идут INSERTы, а данные копятся, а не модифицируются), при которых не особо важно когда именно подействуют изменения - мгновенно или через несколько секунд, минут. Например, если хотите собирать IPадреса своих посетителей, УРЛы, по которым они ходят или страницы, откуда пришли, время. При добавлении с задержкой скрипт отработает почти мгновенно, еще до выполнения операции.
Операция UPDATE идет в три этапа: поиск того, что будете менять, затем запись данных, обновление индексов. При этом, чем больше таблица, тем дольше поиск. Если есть индексы, то операция кешируется и выполняется достаточно быстро. Но сам процесс очень емкий. И только дурак не догонит, что большая таблица со множеством индексов и записей, будет тормозить при UPDATE. INSERT же выполняется одним залпом, очень быстро. Поэтому обычно используют аддитивные записи (вставками INSERT) во временные таблицы, потом блокируют основные талицы, суммируют обновления, и плюют их в основную таблицу. Получается, что в основном, главные таблицы работают только в режиме вывода, а обновления идут гораздо реже и быстрее. Например, можно копить данные о загрузках новостей во временной таблице, а по крону или иным образом обновлять счетчик каждые 10 минут (или реже). Это ускорит работу сервера.
При запросах SELECT * FROM таблица скрипт получит все поля данной таблицы. А нужно ли это? Использование * ведет к лишнему расходу ресурсов. Гораздо эффективнее использовать точные названия полей, которые нужны скрипту. Например: SELECT id,name FROM таблица. При таком запросе передача займет меньше времени и понадобится меньше ресурсов. Старайтесь ограничивать вывод при помощи директивы LIMIT. Это также ускоряет вывод.
Поиск по БД идет быстрее если вместо LIKE '%слово%', ставить 'слово%'. Операции с шаблонами регулярных выражений кешируются только в том случае, если в начале отсутствует символ %. Поэтому при построении поисковых запросов с LIKE избегайте начинающих символов %.
При построении таблиц для наиболее используемых полей (при поиске, сортировке и т.д.) обязательно создавайте индексы. Без индексов таблицы будут сильно тормозить. Индексы служат для кеширования и позволяют существенно ускорить вывод данных из таблиц. При этом таблицы будут занимать больше места на диске и в памяти. Но это в наше время не проблема.
Используйте надлежащий тип полей для своих записей. Тип TINYINT занимает 1 байт - самый быстрый. Таблицы с MEDIUMINT быстрее таблиц с INT. Если ставить полям свойство NOT NULL, то в целом их работа будет быстрее. VARCHAR медленее CHAR, поэтому таблицы переменной длины (где есть тип VARCHAR или TEXT) занимают меньше дискового пространства, но работают медленнее.
По своему опыту скажу, что для большинства сайтов подходят изложенные советы по работе с MySQL. Чтобы еще больше ускорить свой сервер, советую частоиспользуемые операции проводить по крону выделенными процессами и писать данные в различные файлы. Например, раз в 20 минут запускать скрипт, который будет создавать файл с новостями. Или например, генерить файл с новостями при их добавлениях или обновлениях. Таким образом, вы экономите на каждом обращении к БД. Интерактивность при этом не теряется, а производительность увеличивается во много раз. Особенно, повторяю, при высокой посещаемости ресурса. Старайтесь отделить интерактивные операции от фоновых. Например, на ПротоПлексе работает один интерактивный движок, но в фоне по заданиям трудятся с десяток различных роботов, которые генерируют часто вызываемые страницы, рассылают письма и т.д. Крупный сайт - это не только то, что вы видите, но и бек-енд (обратная сторона). В фоновом режиме можно быстро и эффективно готовить контент, освобождая основной движок от лишней работы.
В общем, основы должны быть всем понятны. Дробите все на мелочи, будь то запросы, таблицы или операции. Структура БД должна быть такой, чтобы не выполнялось ничего лишнего. Регулярно проводите OPTIMIZE на таблицах с переменной длиной, особенно, если в них идут удаления записей. Тестируйте свои запросы на скорость, упрощайте их.
Бурное развитие телекоммуникаций застало приход нового тысячелетия в новом витке технологических преобразований. Не остался в стороне и Web-Hosting как одна из профилирующих услуг интернет-сервиса. И если стремительное развитие IT характеризовалось, прежде всего, широко представленным предложением виртуального (в т.ч. бесплатного) хостинга, то новое десятилетие отмечает возросший интерес к разного рода технологиям выделенных серверов (dedicated servers) и co-location.
Что такое co-location? Co-location (colocation, collocation) дословно - это размещение физической машины клиента в специально оборудованном помещении провайдера на его технической площадке (в дата-центре). Помимо собственно размещения в базовый набор услуг по co-location входит:
Предоставление определенного объема предоплаченного трафика (входящего или исходящего, в зависимости от провайдера) или полосы пропускания;
Подключение к внешним каналам с высокой пропускной способностью (от 100 Мбит/c), наличие резервных каналов;
Повышенный уровень безопасности (система бесперебойного электропитания, климат-контроль, backup, охрана от физического проникновения посторонних на техническую площадку и т.д.);
Круглосуточная поддержка;
Оперативное устранение неисправностей непосредственно "на месте" (on-site).
Смежной с co-location является услуга аренды выделенного сервера (сервер не принадлежит клиенту, а взят в аренду у провайдера). В базовый набор услуг при аренде выделенного сервера обычно входит в дополнение к выше перечисленному :
Программное обеспечение для управления функциями сервера;
Услуга аренды сервера интересна в большей степени клиентам, территориально удаленным от коммуникационных центров (в России это Москва и Санкт-Петербург), а также тем, кто не хочет вкладывать деньги в покупку сервера, и тем у кого нет возможности инсталировать сервер своими силами, т.к. для этого нужно обладать знаниями системного администратора.
Co-location и dedicated существенно расширяют возможности веб-узла и являются единственно возможным решением для некоторых интернет-проектов. Как правило, к услугам аренды и размещения сервера прибегают при высоких требованиях к безопасности, потреблении большого объема трафика, высокой нагрузке на вычислительные мощности. Ведь при виртуальном хостинге ресурсы сервера делятся на всех клиентов размещенных на нем, и в случае появления высоко загруженного ресурса на сервере, вероятен отказ в обслуживании. Кроме того, безопасность виртуального хостинга вызывает большие сомнения: в 80% случаев взломы таких серверов производятся самими же клиентами. Немаловажным фактором при выборе выделенного сервера является возможность использования различного программного обеспечения и полный контроль над сервером. Последнее обстоятельство позволяет реализовать проект любой сложности с гарантированной защищенностью данных; для высоко загруженных проектов возможна реализация распределения вычислительной и сетевой нагрузки по нескольким серверам.
Среди проектов, решение которых в сети Интернет требует услуги co-location или выделенного сервера, следует назвать:
поисковые системы (www.yandex.ru)
фото-галереи (www.alenmax.ru)
виртуальные магазины (www.ozon.ru)
хостинг-провайдеры (www.alexhost.ru)
on-line базы данных (www.integrum.ru)
крупные проекты (www.uptime.ru)
интернет-версии оффлайновых СМИ (www.comprice.ru)
сайты с большим трафиком (www.mail.ru)
особо важные проекты (www.government.ru)
порталы (www.interpress.ru)
Несмотря на непространственную природу Интернет, широкое распространение спроса на услуги co-location в последнее время является своеобразной реакцией на распространение виртуального хостинга. Можно сказать, что в случае заключения контракта на co-location абонент покупает прежде всего определенное географическое место. Это место может характеризоваться особым географическим положением провайдера, включенностью в оптимальную телекоммуникационную инфраструктуру или, что тоже важно, хотя бы как психологический фактор, относительной близостью к главному офису заказчика.
Учитывая все эти факторы можно уверенно прогнозировать стремительное развитие данного вида web-услуг в Санкт-Петербурге. Данный регион - являющийся важнейшим телекоммуникационным центром России, местом, где пересекаются основные магистральные линии, связывающие страну с мировыми коммуникациями, - является вторым по экономической значимости регионом РФ. Более низкая по отношению к Москве затратная часть IT-бизнеса, высокий профессиональный уровень кадров, быстрое экономическое развитие региона в целом позволяют прогнозировать развитие спроса на услуги co-location и dedicated на петербургском рынке.
Представляю на Ваш суд утилиту быстрого поиска по базе данных. Данная технология производит поиск по полям, преобразуя их значения в строки (все значения преобразуются в верхний регистр, включая действительные числа).
Данное решение может быть не самым быстрым, однако на поверку оно оказывается быстрее остальных, обнаруженных мною в Интернете (может вам повезет больше). Более того, представьте, что действительное значение какого-либо поля равно 4.509375354, а значение поиска равно 7, в этом случае утилита засчитает "попадание". Утилита удобна также тем, что она за один проход производит поиск более, чем в одном поле.
Это удобно, если у Вас имеются, к примеру, два поля с адресами. Это моя первая "серьезная" разработка, так как первое, с чем я столкнулся, изучая Delphi, стала необходимость включения процедуры поиска в любое приложение, работающее с базой данных. А так как поиск - вещь тоже сугубо специфическая, как и любое приложение, то мне пришлось побороть свой страх перед "крутым программированием" и попробовать написать свой поисковый механизм, удовлетворивший меня (и, надеюсь, других) своей скоростью и возможностью "мульти"-поиска по нескольким полям.
Я надеюсь, что он поможет тем программистам, кто часто сталкивается с подобными задачами. Технология довольно легка для понимания, но если у Вас возникли какие-либо вопросы, пошлите мне письмо электронной почтой, я буду рад Вам помочь. Посмотрев код, можно легко узнать поддерживаемые типы полей (добавить новые не составит проблем).
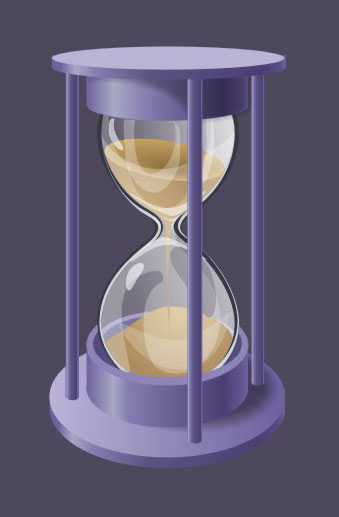
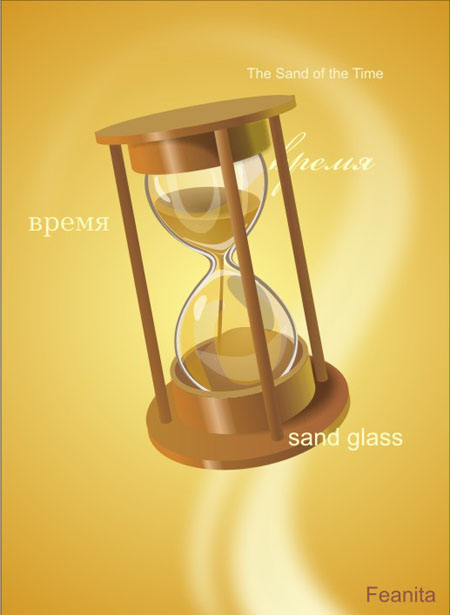
Эта первая статья, которая открывает цикл статей о работе с графическим редактором Corel Draw. Думаю, они помогут всем желающим обучится работать с векторной графикой. Раскрыть для себя все возможности вектора.
Попробуем нарисовать время, а верней его оболочку в виде песочных часов.
Corel Draw. Рисуем часы.
Эта первая статья, которая открывает цикл статей о работе с графическим редактором Corel Draw. Думаю, они помогут всем желающим обучится работать с векторной графикой. Раскрыть для себя все возможности вектора.
Попробуем нарисовать время, а верней его оболочку в виде песочных часов.
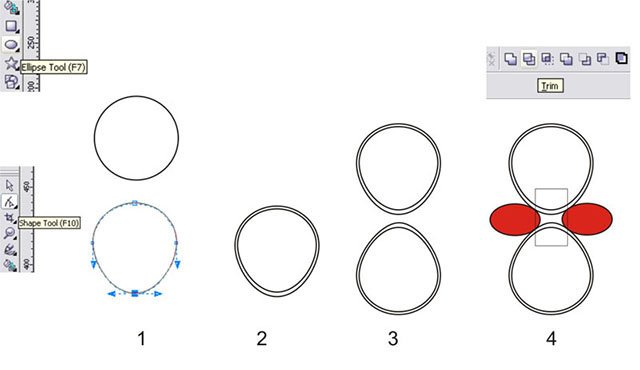
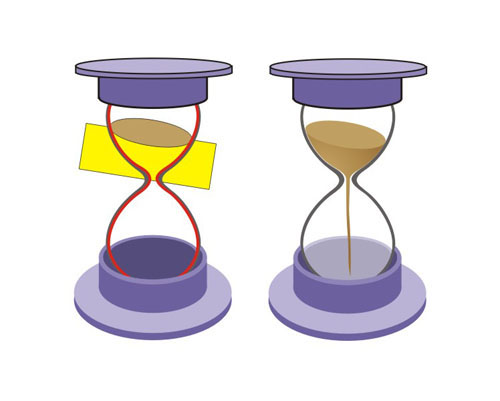
1. Инструментом Ellipse Tool (F7) рисуем круг, для ровного круга зажимаем Ctrl, затем конвертируем круг в кривую Arrange-Convert to curves(Ctrl+Q)
взяв нижнюю точку, приспустим её вниз, как на рисунке!
2. Копируем этот овал (Shift+ тащим Pick Tool к середине объекта) и немного дорабатываем его форму, сделаем его немного тупее (кстати, скопируйте этот внутренний овал и положите его в уголок, он нам еще пригодится!).
3. выделим первые два объекта и скопируем их вниз (выделяем Pick tool, зажимаем Ctrl и тащим)
полученные объекты немного вытянем из верхней точки, как рисунке. На нём, кстати, не очень видно у вас должно быть поострее! Делаем мы это специально потому, что на наши будущие часы мы будем смотреть немного сверху!
4. Теперь инструментом Elipse Tool (F7) нарисуем овал, скопируем его и расположим как на рисунке, сверху инструментом Rectangle Tool рисуем прямоугольник!
5. Обрезаем кружками квадрат, для этого сначала выделяем круг, затем квадрат (зажав Shift) и щелкаем по кнопке Trim.
Повторяем это всё со вторым кругом.
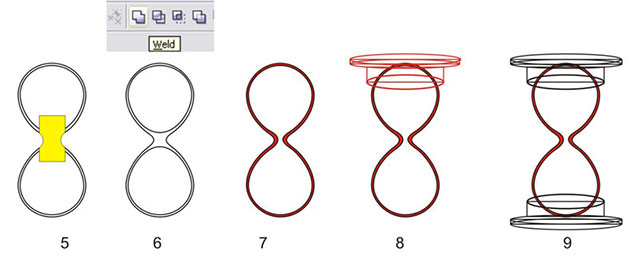
6. Теперь выделим два больших овала и нажмем Weld! Смотрим, что получилось!
кстати, на этом этапе при объединении могут получиться лишние точки их надо удалить, и если надо поменять тип точки
7. Такой же трюк проделываем с внутренними овалами.
У нас уже есть колба для песка она конечно одна но будем называть её двумя объектами большой колбой и малой (внутренней).
Возьмите внутреннюю "колбу" и вырежьте отверстие. Но её не удаляйте!
8. Теперь берем опять инструмент Elise Tool (F7), рисуем овал, затем копируем его и размещаем две копии наверху,
чем выше круг тем он должен быть уже! Дорисуем два прямоугольника, как на рисунке!
9. Выделим пять последних фигур, скопируем и утащим вниз объекта ( отзеркалив их) и забудем о них на некоторое время!
10. Сосредоточим внимание на верхней части!
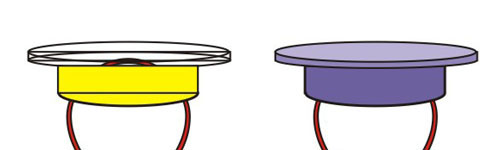
Объединим нижний овал с большим прямоугольником. Как объединять объекты вы уже знаете.
Теперь объединим средний овал и небольшой прямоугольник. Если вы зальёте эти объекты, получится как на рисунке.
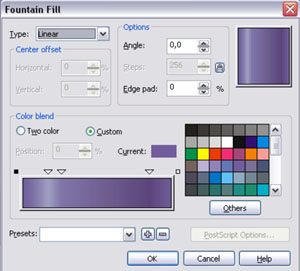
11. Заливаем объекты инструментом Fountain Fill Dialog (F11) или кликаем по палитре сбоку левой кнопкой мыши.
Если вдруг у вас объекты будут расположены в другой последовательности, то для того что бы верхний овал был самым верхним, жмем Shift+Page Up (самым нижним Shift+Page Down) если надо сместить только на один слой Ctrl+Page Up (Down)
Не уделяйте сейчас внимание заливке, о ней поговорим потом.
12. Теперь пошли вниз. Почему мы просто не копируем верхнюю часть? Потому что линия горизонта над предметом низ нам видно больше и вид там будет совершенно другой.
Рисуем заново все объекты или используете то, что вначале утащили вниз в запасник!
Берем овал, обратите внимание, как он расположен и растяните его по высоте, теперь мы видим его больше. Смело копируйте его в середину!
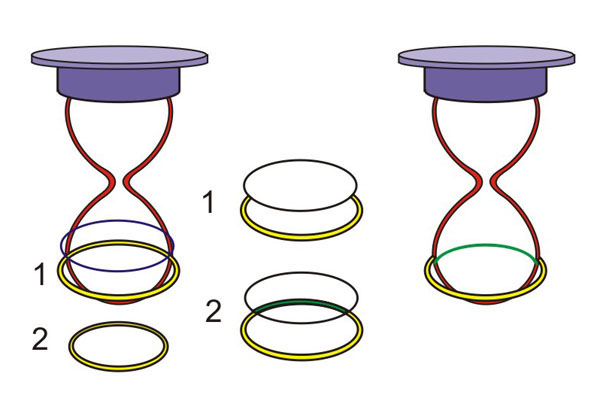
Вырежьте меньшим дырку в большем. Он обозначен желтым цветом! Меньший положим сбоку, потом еще попользуем!
13. Скопируем колечко и уменьшим его немного, смотрите как на рисунке. Для того, что бы было понятнее, назовём колечки 1(большее) и 2(меньшее).
Берем колечко 1-нарисуйте любую форму и обрежьте им колечко, можно обрезать тем овалом, что мы отложили. Обратите внимание на уголки!
14. Берем запасное кольцо 2, располагаем, как на рисунке затем рисуем овал и обрезаем им колечко, с помощью Intersectin. Полученная форма выделена зеленым. Теперь совместим их.
Это будет наше преломление стеклом. Если бы у нас был фон с узорами, он бы тоже должен был преломиться!
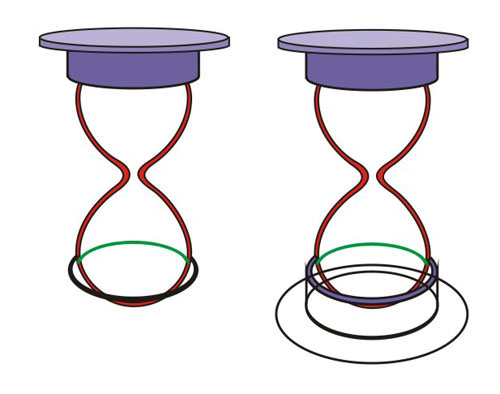
15. Дальше уже известным нам методом объединения и обрезки, получаем из прямоугольника и овала, нижнюю часть подставки. Помним что овал у нас теперь очень широкий.
16. Дорисовываем основание подставки тем же методом, что и верх. Здесь используется объединение готовых форм потому что нам важно сделать симметричный объект. Возьмем отложенный овал и подложим его в самый низ!
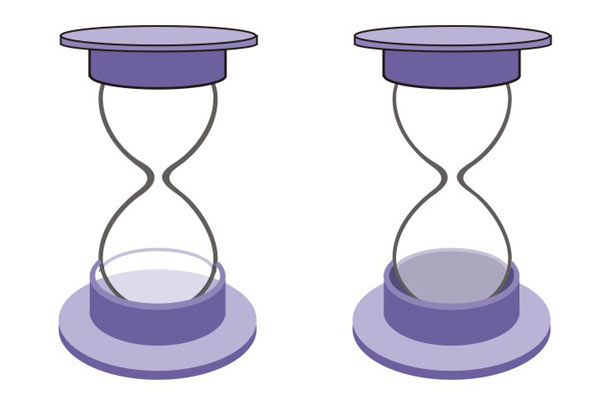
17. Вот почти всё готово! Меньшую "колбу" заливаем и делаем ей прозрачность инструментом Interactive transparenci Tool
Заливаем все, чтоб нам было понятно, что это у нас такое! А это часы без песка!
18. Теперь рисуем сам песок. Сначала рисуем овал, наклоняем его, на рисунке песок сыплется немного наклонно.
Затем рисуем прямоугольник. Сначала выделяем малую ”колбу”, затем новоиспеченный прямоугольник и жмем Intersect!
Подгоняем точки по узкой форме и заливаем цветом песка. Можно продлить этот объект вниз и нарисовать как бы падающую струйку песка. Добавим несколько песчинок для декоративности.
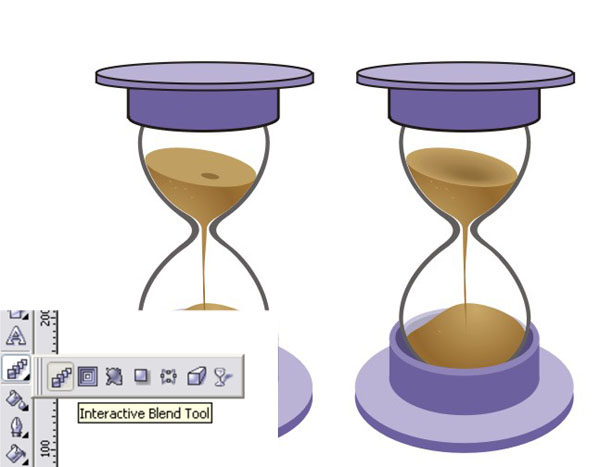
19.На самом верхнем овале песка нарисуем поменьше, зальем более темным цветом и применим интерактивное перетекание Interactive Blend Tool.
Ниже нарисуем небольшую горку упавшего песка. И заливаем просто градиентной заливкой.
20. А теперь самое важное - рисуем блики. Чем больше бликов, тем лучше! Мы можем скопировать меньшую колбу и деформируя её по нескольким точкам также добавить блики. Очень удобно брать её как основу, потому что блики должны идти именно по её форме. Здесь нам пригодится отложенный в начале овал, его тоже удобней подгонять по форме колбы.
Рисуем мелкие блики, деформируя круги по точкам! Затем заливаем и применяем прозрачность.
21. Теперь дорабатываем заливку.
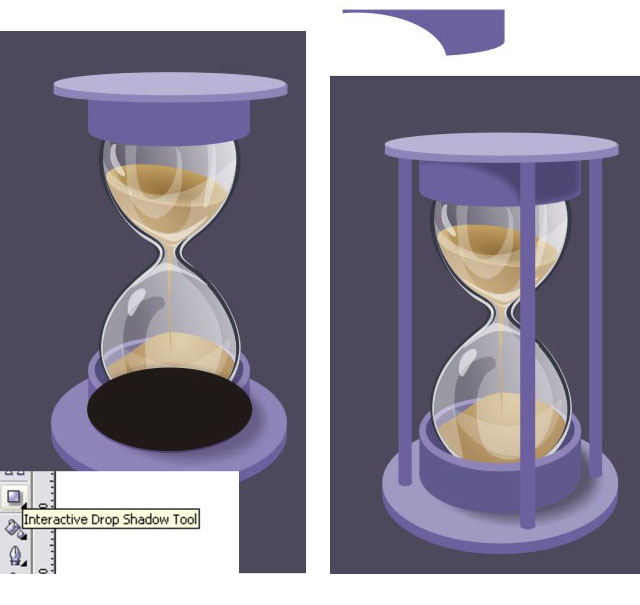
Добавим тени!
Рисуем овал, добавляем тень инструментом Interactive Droр Shadow Tool. Отделим тень от объекта Ctrl+K, удалим овал.
Таким же способом нарисуем тень на верхней подставке.
Еще можно добавить опорные ножки. Рисуют их так же как всё, объединяя квадрат и овал.
В этом уроке изложен принцип рисования подобной формы вы можете усложнить или облегчить саму форму, добавить красивых деталей, прорисовать блики, инкрустировать корпус камушками... В общем, фантазируйте!
Информация в локальных сетях, как правило, передается отдельными порциями, кусками, называемыми в различных источниках пакетами (packets), кадрами (frames) или блоками. Причем предельная длина этих пакетов строго ограничена (обычно величиной в несколько килобайт). Ограничена длина пакета и снизу (как правило, несколькими десятками байт). Выбор пакетной передачи связан с несколькими важными соображениями.
Назначение пакетов и их структура
Информация в локальных сетях, как правило, передается отдельными порциями, кусками, называемыми в различных источниках пакетами (packets), кадрами (frames) или блоками. Причем предельная длина этих пакетов строго ограничена (обычно величиной в несколько килобайт). Ограничена длина пакета и снизу (как правило, несколькими десятками байт). Выбор пакетной передачи связан с несколькими важными соображениями.
Локальная сеть, как уже отмечалось, должна обеспечивать качественную, прозрачную связь всем абонентам (компьютерам) сети. Важнейшим параметром является так называемое время доступа к сети (access time), которое определяется как временной интервал между моментом готовности абонента к передаче (когда ему есть, что передавать) и моментом начала этой передачи. Это время ожидания абонентом начала своей передачи. Естественно, оно не должно быть слишком большим, иначе величина реальной, интегральной скорости передачи информации между приложениями сильно уменьшится даже при высокоскоростной связи.
Ожидание начала передачи связано с тем, что в сети не может происходить несколько передач одновременно (во всяком случае, при топологиях шина и кольцо). Всегда есть только один передатчик и один приемник (реже – несколько приемников). В противном случае информация от разных передатчиков смешивается и искажается. В связи с этим абоненты передают свою информацию по очереди. И каждому абоненту, прежде чем начать передачу, надо дождаться своей очереди. Вот это время ожидания своей очереди и есть время доступа.
Если бы вся требуемая информация передавалась каким-то абонентом сразу, непрерывно, без разделения на пакеты, то это привело бы к монопольному захвату сети этим абонентом на довольно продолжительное время. Все остальные абоненты вынуждены были бы ждать окончания передачи всей информации, что в ряде случаев могло бы потребовать десятков секунд и даже минут (например, при копировании содержимого целого жесткого диска). С тем чтобы уравнять в правах всех абонентов, а также сделать примерно одинаковыми для всех них величину времени доступа к сети и интегральную скорость передачи информации, как раз и применяются пакеты (кадры) ограниченной длины. Важно также и то, что при передаче больших массивов информации вероятность ошибки из-за помех и сбоев довольно высока. Например, при характерной для локальных сетей величине вероятности одиночной ошибки в 10-8пакет длиной 10 Кбит будет искажен с вероятностью 10-4, а массив длиной 10 Мбит – уже с вероятностью 10-1. К тому же выявить ошибку в массиве из нескольких мегабайт намного сложнее, чем в пакете из нескольких килобайт. А при обнаружении ошибки придется повторить передачу всего большого массива. Но и при повторной передаче большого массива снова высока вероятность ошибки, и процесс этот при слишком большом массиве может повторяться до бесконечности.
С другой стороны, сравнительно большие пакеты имеют преимущества перед очень маленькими пакетами, например, перед побайтовой (8 бит) или пословной (16 бит или 32 бита) передачей информации.
Дело в том, что каждый пакет помимо собственно данных, которые требуется передать, должен содержать некоторое количество служебной информации. Прежде всего, это адресная информация, которая определяет, от кого и кому передается данный пакет (как на почтовом конверте – адреса получателя и отправителя). Если порция передаваемых данных будет очень маленькой (например, несколько байт), то доля служебной информации станет непозволительно высокой, что резко снизит интегральную скорость обмена информацией по сети.
Существует некоторая оптимальная длина пакета (или оптимальный диапазон длин пакетов), при которой средняя скорость обмена информацией по сети будет максимальна. Эта длина не является неизменной величиной, она зависит от уровня помех, метода управления обменом, количества абонентов сети, характера передаваемой информации, и от многих других факторов. Имеется диапазон длин, который близок к оптимуму.
Таким образом, процесс информационного обмена в сети представляет собой чередование пакетов, каждый из которых содержит информацию, передаваемую от абонента к абоненту.
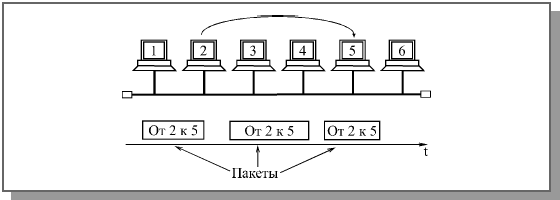
Передача пакетов в сети между двумя абонентами
Рис. 4.1. Передача пакетов в сети между двумя абонентами
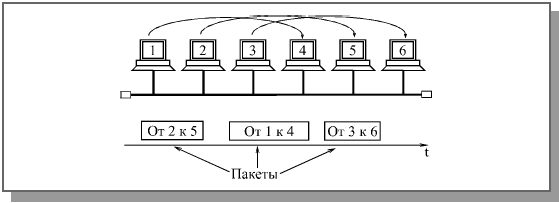
В частном случае (рис. 4.1) все эти пакеты могут передаваться одним абонентом (когда другие абоненты не хотят передавать). Но обычно в сети чередуются пакеты, посланные разными абонентами (рис. 4.2).
Передача пакетов в сети между несколькими абонентами
Рис. 4.2. Передача пакетов в сети между несколькими абонентами
Структура и размеры пакета в каждой сети жестко определены стандартом на данную сеть и связаны, прежде всего, с аппаратурными особенностями данной сети, выбранной топологией и типом среды передачи информации. Кроме того, эти параметры зависят от используемого протокола (порядка обмена информацией).
Но существуют некоторые общие принципы формирования структуры пакета, которые учитывают характерные особенности обмена информацией по любым локальным сетям.
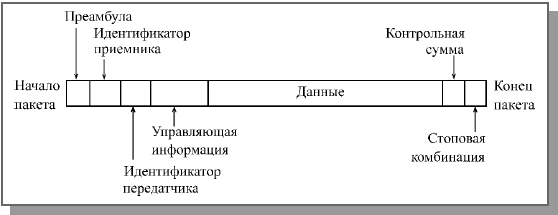
Чаще всего пакет содержит в себе следующие основные поля или части (рис. 4.3):
Типичная структура пакета
Рис. 4.3. Типичная структура пакета
* Стартовая комбинация битов или преамбула, которая обеспечивает предварительную настройку аппаратуры адаптера или другого сетевого устройства на прием и обработку пакета. Это поле может полностью отсутствовать или же сводиться к единственному стартовому биту.
* Сетевой адрес (идентификатор) принимающего абонента, то есть индивидуальный или групповой номер, присвоенный каждому принимающему абоненту в сети. Этот адрес позволяет приемнику распознать пакет, адресованный ему лично, группе, в которую он входит, или всем абонентам сети одновременно (при широком вещании).
* Сетевой адрес (идентификатор) передающего абонента, то есть индивидуальный номер, присвоенный каждому передающему абоненту. Этот адрес информирует принимающего абонента, откуда пришел данный пакет. Включение в пакет адреса передатчика необходимо в том случае, когда одному приемнику могут попеременно приходить пакеты от разных передатчиков.
* Служебная информация, которая может указывать на тип пакета, его номер, размер, формат, маршрут его доставки, на то, что с ним надо делать приемнику и т.д.
* Данные (поле данных) – это та информация, ради передачи которой используется пакет. В отличие от всех остальных полей пакета поле данных имеет переменную длину, которая, собственно, и определяет полную длину пакета. Существуют специальные управляющие пакеты, которые не имеют поля данных. Их можно рассматривать как сетевые команды. Пакеты, включающие поле данных, называются информационными пакетами. Управляющие пакеты могут выполнять функцию начала и конца сеанса связи, подтверждения приема информационного пакета, запроса информационного пакета и т.д.
* Контрольная сумма пакета – это числовой код, формируемый передатчиком по определенным правилам и содержащий в свернутом виде информацию обо всем пакете. Приемник, повторяя вычисления, сделанные передатчиком, с принятым пакетом, сравнивает их результат с контрольной суммой и делает вывод о правильности или ошибочности передачи пакета. Если пакет ошибочен, то приемник запрашивает его повторную передачу. Обычно используется циклическая контрольная сумма (CRC). Подробнее об этом рассказано в главе 7.
* Стоповая комбинация служит для информирования аппаратуры принимающего абонента об окончании пакета, обеспечивает выход аппаратуры приемника из состояния приема. Это поле может отсутствовать, если используется самосинхронизирующийся код, позволяющий определять момент окончания передачи пакета.
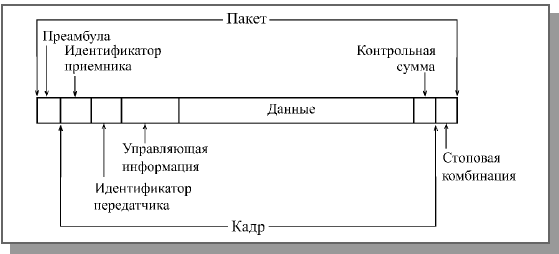
Вложение кадра в пакет
Рис. 4.4. Вложение кадра в пакет
Нередко в структуре пакета выделяют всего три поля:
* Начальное управляющее поле пакета (или заголовок пакета), то есть поле, включающее в себя стартовую комбинацию, сетевые адреса приемника и передатчика, а также служебную информацию.
* Поле данных пакета.
* Конечное управляющее поле пакета (заключение, трейлер), куда входят контрольная сумма и стоповая комбинация, а также, возможно, служебная информация.
Как уже упоминалось, помимо термина "пакет" (packet) в литературе также нередко встречается термин "кадр" (frame). Иногда под этими терминами имеется в виду одно и то же. Но иногда подразумевается, что кадр и пакет различаются. Причем единства в объяснении этих различий не наблюдается.
В некоторых источниках утверждается, что кадр вложен в пакет. В этом случае все перечисленные поля пакета кроме преамбулы и стоповой комбинации относятся к кадру (рис. 4.4). Например, в описаниях сети Ethernet говорится, что в конце преамбулы передается признак начала кадра.
В других, напротив, поддерживается мнение о том, что пакет вложен в кадр. И тогда под пакетом подразумевается только информация, содержащаяся в кадре, который передается по сети и снабжен служебными полями.
Во избежание путаницы, в данной книге термин "пакет" будет использоваться как более понятный и универсальный.
В процессе сеанса обмена информацией по сети между передающим и принимающим абонентами происходит обмен информационными и управляющими пакетами по установленным правилам, называемым протоколом обмена. Это позволяет обеспечить надежную передачу информации при любой интенсивности обмена по сети.
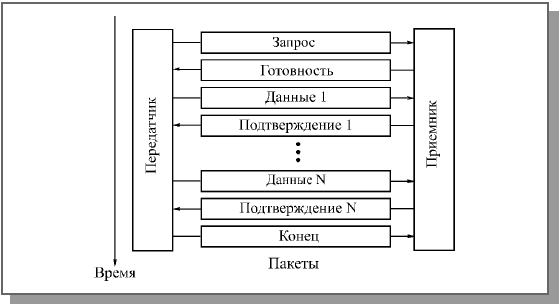
Пример простейшего протокола показан на рис. 4.5.
Пример обмена пакетами при сеансе связи
Рис. 4.5. Пример обмена пакетами при сеансе связи
Сеанс обмена начинается с запроса передатчиком готовности приемника принять данные. Для этого используется управляющий пакет "Запрос". Если приемник не готов, он отказывается от сеанса специальным управляющим пакетом. В случае, когда приемник готов, он посылает в ответ управляющий пакет "Готовность". Затем начинается собственно передача данных. При этом на каждый полученный информационный пакет приемник отвечает управляющим пакетом "Подтверждение". В случае, когда пакет данных передан с ошибками, в ответ на него приемник запрашивает повторную передачу. Заканчивается сеанс управляющим пакетом "Конец", которым передатчик сообщает о разрыве связи. Существует множество стандартных протоколов, которые используют как передачу с подтверждением (с гарантированной доставкой пакета), так и передачу без подтверждения (без гарантии доставки пакета). Подробнее о протоколах обмена будет рассказано в следующей главе.
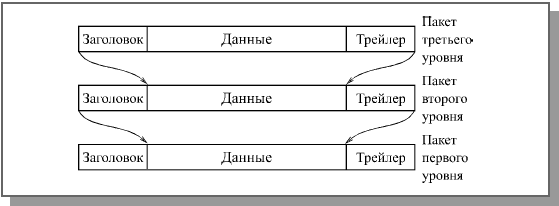
При реальном обмене по сети применяются многоуровневые протоколы, каждый из уровней которых предполагает свою структуру пакета (адресацию, управляющую информацию, формат данных и т.д.). Ведь протоколы высоких уровней имеют дело с такими понятиями, как файл-сервер или приложение, запрашивающее данные у другого приложения, и вполне могут не иметь представления ни о типе аппаратуры сети, ни о методе управления обменом. Все пакеты более высоких уровней последовательно вкладываются в передаваемый пакет, точнее, в поле данных передаваемого пакета (рис. 4.6). Этот процесс последовательной упаковки данных для передачи называется также инкапсуляцией пакетов.
Многоуровневая система вложения пакетов
Рис. 4.6. Многоуровневая система вложения пакетов
Каждый следующий вкладываемый пакет может содержать собственную служебную информацию, располагающуюся как до данных (заголовок), так и после них (трейлер), причем ее назначение может быть различным. Безусловно, доля вспомогательной информации в пакетах при этом возрастает с каждым следующим уровнем, что снижает эффективную скорость передачи данных. Для увеличения этой скорости предпочтительнее, чтобы протоколы обмена были проще, и уровней этих протоколов было меньше. Иначе никакая скорость передачи битов не поможет, и быстрая сеть может передавать файл дольше, чем медленная сеть, которая пользуется более простым протоколом.
Обратный процесс последовательной распаковки данных приемником называется декапсуляцией пакетов.
Средой передачи информации называются те линии связи (или каналы связи), по которым производится обмен информацией между компьютерами. В подавляющем большинстве компьютерных сетей (особенно локальных) используются проводные или кабельные каналы связи, хотя существуют и беспроводные сети, которые сейчас находят все более широкое применение, особенно в портативных компьютерах.
Информация в локальных сетях чаще всего передается в последовательном коде, то есть бит за битом. Такая передача медленнее и сложнее, чем при использовании параллельного кода. Однако надо учитывать то, что при более быстрой параллельной передаче (по нескольким кабелям одновременно) увеличивается количество соединительных кабелей в число раз, равное количеству разрядов параллельного кода (например, в 8 раз при 8-разрядном коде). Это совсем не мелочь, как может показаться на первый взгляд. При значительных расстояниях между абонентами сети стоимость кабеля вполне сравнима со стоимостью компьютеров и даже может превосходить ее. К тому же проложить один кабель (реже два разнонаправленных) гораздо проще, чем 8, 16 или 32. Значительно дешевле обойдется также поиск повреждений и ремонт кабеля.
Но это еще не все. Передача на большие расстояния при любом типе кабеля требует сложной передающей и приемной аппаратуры, так как при этом необходимо формировать мощный сигнал на передающем конце и детектировать слабый сигнал на приемном конце. При последовательной передаче для этого требуется всего один передатчик и один приемник. При параллельной же количество требуемых передатчиков и приемников возрастает пропорционально разрядности используемого параллельного кода. В связи с этим, даже если разрабатывается сеть незначительной длины (порядка десятка метров) чаще всего выбирают последовательную передачу.
К тому же при параллельной передаче чрезвычайно важно, чтобы длины отдельных кабелей были точно равны друг другу. Иначе в результате прохождения по кабелям разной длины между сигналами на приемном конце образуется временной сдвиг, который может привести к сбоям в работе или даже к полной неработоспособности сети. Например, при скорости передачи 100 Мбит/с и длительности бита 10 нс этот временной сдвиг не должен превышать 5—10 нс. Такую величину сдвига дает разница в длинах кабелей в 1—2 метра. При длине кабеля 1000 метров это составляет 0,1—0,2%.
Надо отметить, что в некоторых высокоскоростных локальных сетях все-таки используют параллельную передачу по 2—4 кабелям, что позволяет при заданной скорости передачи применять более дешевые кабели с меньшей полосой пропускания. Но допустимая длина кабелей при этом не превышает сотни метров. Примером может служить сегмент 100BASE-T4 сети Fast Ethernet.
Промышленностью выпускается огромное количество типов кабелей, например, только одна крупнейшая кабельная компания Belden предлагает более 2000 их наименований. Но все кабели можно разделить на три большие группы:
* электрические (медные) кабели на основе витых пар проводов (twisted pair), которые делятся на экранированные (shielded twisted pair, STP) и неэкранированные (unshielded twisted pair, UTP);
* электрические (медные) коаксиальные кабели (coaxial cable);
* оптоволоконные кабели (fiber optic).
Каждый тип кабеля имеет свои преимущества и недостатки, так что при выборе надо учитывать как особенности решаемой задачи, так и особенности конкретной сети, в том числе и используемую топологию.
Можно выделить следующие основные параметры кабелей, принципиально важные для использования в локальных сетях:
* Полоса пропускания кабеля (частотный диапазон сигналов, пропускаемых кабелем) и затухание сигнала в кабеле. Два этих параметра тесно связаны между собой, так как с ростом частоты сигнала растет затухание сигнала. Надо выбирать кабель, который на заданной частоте сигнала имеет приемлемое затухание. Или же надо выбирать частоту сигнала, на которой затухание еще приемлемо. Затухание измеряется в децибелах и пропорционально длине кабеля.
* Помехозащищенность кабеля и обеспечиваемая им секретность передачи информации. Эти два взаимосвязанных параметра показывают, как кабель взаимодействует с окружающей средой, то есть, как он реагирует на внешние помехи, и насколько просто прослушать информацию, передаваемую по кабелю.
* Скорость распространения сигнала по кабелю или, обратный параметр – задержка сигнала на метр длины кабеля. Этот параметр имеет принципиальное значение при выборе длины сети. Типичные величины скорости распространения сигнала – от 0,6 до 0,8 от скорости распространения света в вакууме. Соответственно типичные величины задержек – от 4 до 5 нс/м.
* Для электрических кабелей очень важна величина волнового сопротивления кабеля. Волновое сопротивление важно учитывать при согласовании кабеля для предотвращения отражения сигнала от концов кабеля. Волновое сопротивление зависит от формы и взаиморасположения проводников, от технологии изготовления и материала диэлектрика кабеля. Типичные значения волнового сопротивления – от 50 до 150 Ом.
В настоящее время действуют следующие стандарты на кабели:
* EIA/TIA 568 (Commercial Building Telecommunications Cabling Standard) – американский;
* ISO/IEC IS 11801 (Generic cabling for customer premises) – международный;
* CENELEC EN 50173 (Generic cabling systems) – европейский.
Эти стандарты описывают практически одинаковые кабельные системы, но отличаются терминологией и нормами на параметры.
Image Styler - замечательная программа для создания графики для Web. Особенно эта программа нравиться новичкам (тем, кто никогда не имел дело с графическими редакторами, или толком в них не разбираются).
Графика без труда (Image Styler).
Image Styler - замечательная программа для создания графики для Web. Особенно эта программа нравиться новичкам (тем, кто никогда не имел дело с графическими редакторами, или толком в них не разбираются).
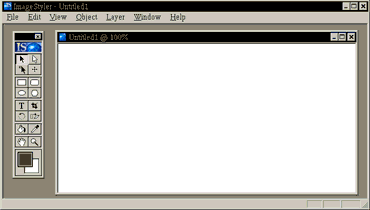
Открываем Image Styler. По умолчанию программа уже создала новый документ. Теперь надо предать этому документу необходимый размер. Для этого надо выбрать пункты Edit - Canvas Size - и появится табличка, в которой можно задать нужные размеры листа. Создадим лист побольше ( width - 600, а height - 500). Потом можно сохранить свое меню как угодно, одной картинкой или несколькими, поэтому не обязательно делать много документов.
Что можно нарисовать на первых страницах? – кнопки и несложный логотип.
Как создавать кнопки.
Вызываем меню с основными функциями, выбрав пункт в верхнем меню Window - Tools.
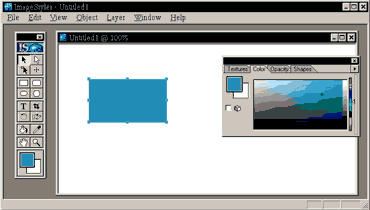
В появившемся меню видны изображения: квадрата, квадрата с закругленными краями, круга и многоугольника - берем одну из этих опций (пусть будет квадрат) и рисуем квадрат нужных размеров.
Чтобы квадрат, который рисуем на белом фоне, был виден, надо задать ему цвет. Для этого выбираем пункт меню (вверху) Window - Color - появится таблица с цветами. И в этой таблице ищем нужный цвет квадрата.
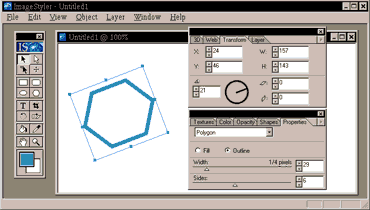
Можно задать цвет сразу нескольких объектов, для этого надо выделить их все. Если надо создать кнопку определенных размеров, то тогда надо выбрать пункт меню Window - Tranform - здесь можно задать положение квадрата относительно листа (X, Y), размеры квадрата в пикселях (W, H), вращение (rotation) в градусах и наклон (skew) относительно горизонтали или вертикали. Для первого раза понадобятся параметры высоты и ширины (width и height). Допустим, что кнопку надо сделать на основе многоугольника. Рисуем - получаем ромб. Как сделать, чтобы углов было больше (пятиугольник, шестиугольник и т.д.)? Или меньше (треугольник)? Идем в меню: Window - Properties. Для работы с объектом (ромбом), надо его выделить. Теперь можно сделать его пятиугольником (шести... и т.д.) - sides - этот параметр задает количество сторон многоугольника (максимум 10). Можно сделать его рамкой-контуром (outlinе) и снова наполненным (fill). Если сделать многоугольник контуром, то нужно задать толщину контура (width) в пикселях.
Для разных объектов properties (свойства) разные. Чтобы понять работу со свойствами надо с ними поэкспериментировать.
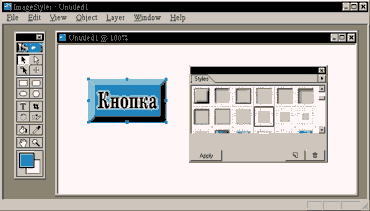
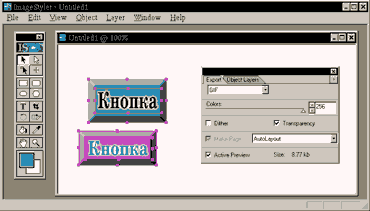
Вернемся к квадрату. Нарисовали, раскрасили, задали нужный размер. Теперь как его сделать кнопкой? Очень просто - Window - Styles. Появится окошко со стилями. Выделяем квадрат или квадраты и выбираем нужный стиль (с тенью, без тени и любой другой).
Сделать надпись на кнопке тоже не очень сложно. Вернемся к основному меню (Tools). Жмем кнопку с буквой Т - это означает текст. Теперь левой кнопкой мыши щелкаем в любом месте нашего "листа" (помните, текст такой же объект как квадрат, вы можете задать ему Стиль, поменять также цвет, задать вращение и так далее). Появится обычная табличка (стандартная для всех графических и текстовых редакторов) со свойствами только для текста. Выбираем нужный шрифт, нужный размер шрифта, нужное расстояние между буквами. Когда все готово, выделяем текст и перемещаем его так, чтобы он был на квадрате - кнопка с текстом готова.
Стайлер может не понимать русский шрифт. В таком случае пишется нужный текст русскими буквами в блокноте (или другом текстовом редакторе), копируется и вставляется в Image Styler. Это неудобно, но не надо делать картинкой очень много текста.
Чтобы создать идентичные кнопки, но с другими надписями - выделяется квадрат с текстом. Edit - Copy. Edit - Paste. Появится точно такой же квадрат с точно таким же текстом. Отодвигаем его на свободное пространство листа (или выравниваем относительно первой кнопки с надписью). А теперь надо только изменить текст на новой кнопке. Для этого два раза щелкаем левой кнопкой мыши по тексту и вставляем (пишем) новую надпись. Вот так вы очень быстро можно создать меню.
Теперь как сохранить полученный рисунок? Как задать нужный формат (jpg, gif, png)? И можно ли чтобы программа сама написала HTML код для этого рисунка?
Опции для Экспорта картинок: Window - Export. Здесь можно выбрать нужный формат, выбрать какого качества будет картинка. И самое интересное - можно еще до сохранения увидеть, как будет выглядеть картинка, когда ее экспортируют (active preview - только надо поставить галочку).
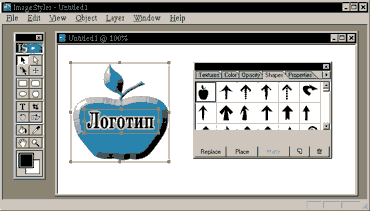
Теперь немного о логотипе. Его также можно создать с помощью Image Styler. Рисуется опять квадрат. Теперь выбирается пункт меню Window - Shapes. Выделить квадрат и придать ему нужную форму. С помощью этой опции можно создавать много разных рисунков, хотя и незатейливых.
Также можно импортировать текстуры, картинки, нарисованные не в Image styler: File - Place as Texture. Таким образом, можно задать текстуру для всего листа (фон), для отдельного объекта, только надо не забывать перед эти нужное выделять.
P.S. Image Styler уже довольно старая программа и Adobe отказалась от ее совершенствовании. Но не стоит расстраиваться программа-то функциональная, да и одно из новых детищ Adobe - Live Motion - как близнец похоже на Image Styler (+ имеет новые, упрощающие вашу жизнь возможности)..
Конечно же вы попадали в такую ситуацию, когда приложение, разработанное вами ранее, могло быть снова использовано в рамках другого проекта. Вначале вы конечно же подумали, что это не создаст никаких проблем. Всего-то необходимо скопировать код из одного каталога в другой! Со временем вы осознали, что проекты могут различаться между собой различными параметрами, пусть даже самыми незначительными. Например, это может быть e-mail адрес на который отсылаются сообщения. В таком случае вам ничего не остается, как открыть множество файлов в редакторе и изменить их содержимое, вставляя нужный e-mail при помощи функции найти/заменить. Эта статья расскажет вам о том, как можно избавить себя от подобной работы, а так же порекомендует ряд дополнительных средств для создания и чтения конфигурационных файлов.
Повторное использование кода
Компьютер был изобретен для того, чтобы избавить человека от лишней работы. Развитие компьютерных технологий привело к тому, что человек стал стремиться все меньше времени проводить за компьютером. Допустим, вы программист. Не будь компьютера, вы бы остались без работы. Но в то же время вы стараетесь с помощью компьютера упростить свою ежедневную работы, с этой целью вы используете, например, функцию автозавершения кода в редакторе. Мы хотим подвести вас к той мысли, что код созданный вами, должен быть организован так, чтобы работы по его модификации были сведены к минимуму. Чаще всего это удается, когда вы создаете код, автоматизирующий рутинные операции, такие как создание и прорисовка формы, а так же отправка e-mail. Однако не стоит забывать, что функции для выполнения рутинных операций никогда не бывают на 100% идентичными в различных приложениях. Один формуляр не похож на другой, а сообщения электронной почты предназначены разным адресатам. Однако логика на уровне приложения остается прежней, функции различаются между собой только некоторыми параметрами. Таким образом, вы должны ясно представлять свою цель – разработать код, параметры которого можно было бы определять извне.
Модульная организация
Для решения этой задачи, планируя структуру приложения, вы должны позаботиться о модульности. То есть вам необходимо поместить часто используемые функции или классы в отдельный файл, который будет подключаться через require_once. В этом случае файлы приложения не будут наполнены избыточным кодом. Допустим, вы часто осуществляете запись в лог-файл. В таком случае было бы неплохо код, выполняющий эту операцию, заключить в рамки класса или функции. Будет еще лучше, если вы воспользуетесь уже готовым классом, взятым из какой-нибудь библиотеки исходных кодов, например PEAR.
Параметры процедурального кода
После того, как вы проанализировали код, выделили повторяющиеся фрагменты, распределили их по классам и функциям, необходимо подумать о выделении необходимых параметров, значения которых будут устанавливаться извне. Если речь идет о процедуральном коде, самым простым решением является использование глобальных переменных, которые необходимо определить в отдельном файле. Это позволит в дальнейшем без проблем изменять их значения.
Листинг 1 демонстрирует функцию, которая занимается отправкой e-mail. В ее теле содержится только одна php-функция - mail(). Таким образом, мы избавляемся от необходимости каждый раз указывать получателя при отправке сообщения. Следующая переменная, которую мы определяем, обозначает префикс, предшествующий теме сообщения. Конфигурационный файл, подключаемый через require_once, мог бы выглядеть следующим образом.
Listing 1
Есть способ лучше
Даже если рассмотренный выше способ и является действенным, однако это не самое лучшее решение. По мере того как код вашего приложения будет усложняться, вырастет и число опций, тогда могут возникнуть следующие проблемы:
Глобальные переменные, которые мы используем, могут породить конфликты в пространстве имен.
В том случае, если конфигурационные файлы редактируются не программистом, а дилетантом, в системе могут возникнуть синтаксические ошибки, например из-за незакрытых кавычек.
Для того, чтобы получить доступ к различным переменным, необходимо обращаться к массиву $_GLOBALS.
Вместо php-модулей существуют другие форматы, которые могут быть легко поняты и изменены дилетантами, а так же php-скриптами. Мы имеем в виду два формата: этого широко используемые операционной системой Windows ini-файлы, а так же формат XML.
PHP уже содержит функцию parse_ini_file(), которая без проблем читает ini-файлы. Такой файл имеет очень простую структуру. Каждой опции может быть присвоено только одно значение, а в качестве оператора присваивания используется знак равенства. Конфигурационный файл из предыдущего примера выглядел бы следующим образом в ini-формате.
После считывания ini-файла, имя которого передается в качестве параметра функции parse_ini_file(), мы получаем ассоциативный массив, имеющий вид:
В листинге 2 находится функция отправки почты, основанная на ini-файлах:
Listing 2
Если вы уже прочитали документацию по функции parse_ini_file(), вы кончено же заметили, что она может принимать и второй параметр. Он необходим, если вы хотите разделить ini-файл на несколько разделов или секций. Предположим, вам необходимо сохранить несколько настроек электронной почты. Тогда ini-файл будет выглядеть следующим образом:
"
Если вы при вызове parse_ini_file() передаете true в качестве второго параметра, в этом случае php будет искать в файле секции, а затем вернет многомерный массив, в котором каждой секции (errors и contact) будет соответствовать определенный набор значений:
Особые значения в ini-файлах
При использовании ini-файлов вы должны иметь в виду, что некоторые особые значения могут быть представлены строками. Допустим, вы определяете значение опции как true или yes (без кавычек), в таком случае они автоматически конвертируются в число 1, а false или no – в пустую строку. К сожалению, при этом не генерируется никакой ошибки. Поэтому не пытайтесь использовать no для сокращенного обозначения Норвегии.
Listing 3
Безопасность
Вы должны понимать то, что если конфигурационный файл используется для хранения важных данных, например паролей, необходимо позаботиться о том, чтобы содержимое такого файла не попало в web-браузер. Простейший выход из положения заключается в том, чтобы хранить конфигурационные файлы вне корневой директории сайта, например здесь:






 Поиск