Книга, которую вы сейчас держите в руках, открывает двери в удивительный
мир защитных механизмов, рассказывая о том,как создаются и вскрываются защиты. Она адресована всем, кто любит захватывающие дух головоломки. Всем, кто проводит свободное (и несвободное) время за копанием в недрах программ и операционной системы. Наконец, всем, кто по роду своей деятельности занимается (постоянно и/или эпизодически) написанием защит и хочет узнать как грамотно и гарантированно противостоять вездесущим хакерам. Настоящий том посвященбазовым основам хакерства – технике работы с отладчиком и дизассемблером. Подробно описаны приемы идентификации и реконструкции ключевых структур исходного языка – функций (в т.ч. виртуальных), локальных и глобальных переменных, ветвлений, циклов, объектов и
их иерархий, математических операторов и т.д.
Семейство протоколов TCP/IP широко применяется во всем мире для объединения компьютеров в сеть Internet. Единая сеть Internet состоит из множества сетей различной физической природы, от локальных сетей типа Ethernet и Token Ring, до глобальных сетей типа NSFNET. Основное внимание в книге уделяется принципам организации межсетевого взаимодействия. Многие технические детали, исторические вопросы опущены. Более подробную информацию о протоколах TCP/IP можно найти в RFC (Requests For Comments) - специальных документах, выпускаемых Сетевым Информационным Центром (Network Information Center - NIC). Приложение 1 содержит путеводитель по RFC, а приложение 2 отражает положение дел в области стандартизации протоколов семейства TCP/IP на начало 1991 года.
В книге приводятся примеры, основанные на реализации TCP/IP в ОС UNIX. Однако основные положения применимы ко всем реализациям TCP/IP.
Надеюсь, что эта книга будет полезна тем, кто профессионально работает или собирается начать работать в среде TCP/IP: системным администраторам, системным программистам и менеджерам сети.
Бурное развитие коммуникационных технологий и в частности Internet технологий, требует от современного молодого человека определенных знаний и умений по поиску, приему и передачи необходимой информации в международной сети - Internet. В связи с этим, в современные учебные программы по информационным технологиям включен такой раздел как "Коммуникационные технологии" который знакомит учащихся с принципами функционирования локальных и глобальных вычислительных сетей, работе с электронной почтой, основами языка разметки гипертекста (HTML – Hyper Text Markup Language).
Данное пособие предназначено для учителей информационных технологий начинающих обучение школьников языку HTML. В пособии даются отдельные уроки по темам – описание тэгов HTML и примеры работоспособных программ по каждой теме. Так же к пособию прилагается диск с уроками, предлагаемыми в пособии и инструментальная программа для создания WEB страниц. Учебно-методическое пособие для преподавателей информатики и информационных технологий.
Чаще всего аналоговое кодирование используется при передаче информации по каналу с узкой полосой пропускания, например, по телефонным линиям в глобальных сетях. Кроме того, аналоговое кодирование применяется в радиоканалах, что позволяет обеспечивать связь между многими пользователями одновременно.
Код RZ
Код RZ (Return to Zero – с возвратом к нулю) – этот трехуровневый код получил такое название потому, что после значащего уровня сигнала в первой половине битового интервала следует возврат к некоему "нулевому", среднему уровню (например, к нулевому потенциалу). Переход к нему происходит в середине каждого битового интервала. Логическому нулю, таким образом, соответствует положительный импульс, логической единице – отрицательный (или наоборот) в первой половине битового интервала.
В центре битового интервала всегда есть переход сигнала (положительный или отрицательный), следовательно, из этого кода приемник легко может выделить синхроимпульс (строб). Возможна временная привязка не только к началу пакета, как в случае кода NRZ, но и к каждому отдельному биту, поэтому потери синхронизации не произойдет при любой длине пакета.
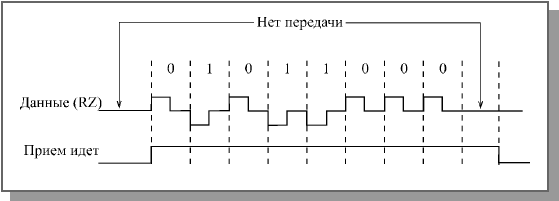
Еще одно важное достоинство кода RZ – простая временная привязка приема, как к началу последовательности, так и к ее концу. Приемник просто должен анализировать, есть изменение уровня сигнала в течение битового интервала или нет. Первый битовый интервал без изменения уровня сигнала соответствует окончанию принимаемой последовательности бит (рис. 3.12). Поэтому в коде RZ можно использовать передачу последовательностями переменной длины.
Определение начала и конца приема при коде RZ
Рис. 3.12. Определение начала и конца приема при коде RZ
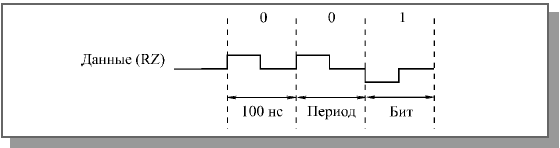
Недостаток кода RZ состоит в том, что для него требуется вдвое большая полоса пропускания канала при той же скорости передачи по сравнению с NRZ (так как здесь на один битовый интервал приходится два изменения уровня сигнала). Например, для скорости передачи информации 10 Мбит/с требуется пропускная способность линии связи 10 МГц, а не 5 МГц, как при коде NRZ (рис. 3.13).
Скорость передачи и пропускная способность при коде RZ
Рис. 3.13. Скорость передачи и пропускная способность при коде RZ
Другой важный недостаток – наличие трех уровней, что всегда усложняет аппаратуру как передатчика, так и приемника.
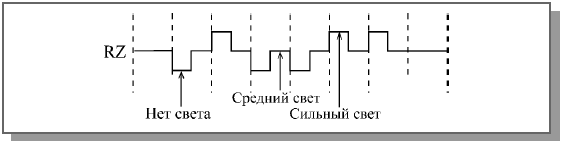
Код RZ применяется не только в сетях на основе электрического кабеля, но и в оптоволоконных сетях. Правда, в них не существует положительных и отрицательных уровней сигнала, поэтому используется три следующие уровня: отсутствие света, "средний" свет, "сильный" свет. Это очень удобно: даже когда нет передачи информации, свет все равно присутствует, что позволяет легко определить целостность оптоволоконной линии связи без дополнительных мер (рис. 3.14).
Использование кода RZ в оптоволоконных сетях
Рис. 3.14. Использование кода RZ в оптоволоконных сетях
Манчестерский код
Манчестерский код (или код Манчестер-II) получил наибольшее распространение в локальных сетях. Он также относится к самосинхронизирующимся кодам, но в отличие от RZ имеет не три, а всего два уровня, что способствует его лучшей помехозащищенности и упрощению приемных и передающих узлов. Логическому нулю соответствует положительный переход в центре битового интервала (то есть первая половина битового интервала – низкий уровень, вторая половина – высокий), а логической единице соответствует отрицательный переход в центре битового интервала (или наоборот).
Как и в RZ, обязательное наличие перехода в центре бита позволяет приемнику манчестерского кода легко выделить из пришедшего сигнала синхросигнал и передать информацию сколь угодно большими последовательностями без потерь из-за рассинхронизации. Допустимое расхождение часов приемника и передатчика может достигать 25%.
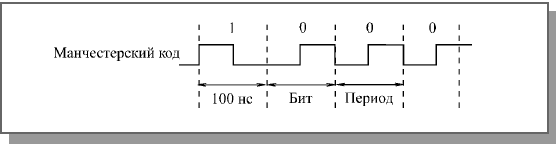
Подобно коду RZ, при использовании манчестерского кода требуется пропускная способность линии в два раза выше, чем при применении простейшего кода NRZ. Например, для скорости передачи 10 Мбит/с требуется полоса пропускания 10 МГц (рис. 3.15).
Скорость передачи и пропускная способность при манчестерском коде
Рис. 3.15. Скорость передачи и пропускная способность при манчестерском коде
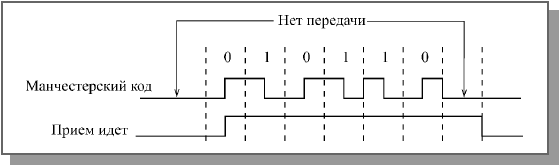
Как и при коде RZ, в данном случае приемник легко может определить не только начало передаваемой последовательности бит, но и ее конец. Если в течение битового интервала нет перехода сигнала, то прием заканчивается. В манчестерском коде можно передавать последовательности бит переменной длины (рис. 3.16). Процесс определения времени передачи называют еще контролем несущей, хотя в явном виде несущей частоты в данном случае не присутствует.
Определение начала и конца приема при манчестерском коде
Рис. 3.16. Определение начала и конца приема при манчестерском коде
Манчестерский код используется как в электрических, так и в оптоволоконных кабелях (в последнем случае один уровень соответствует отсутствию света, а другой – его наличию).
Основное достоинство манчестерского кода – постоянная составляющая в сигнале (половину времени сигнал имеет высокий уровень, другую половину – низкий). Постоянная составляющая равна среднему значению между двумя уровнями сигнала.
Если высокий уровень имеет положительную величину, а низкий – такую же отрицательную, то постоянная составляющая равна нулю. Это дает возможность легко применять для гальванической развязки импульсные трансформаторы. При этом не требуется дополнительного источника питания для линии связи (как, например, в случае использования оптронной гальванической развязки), резко уменьшается влияние низкочастотных помех, которые не проходят через трансформатор, легко решается проблема согласования.
Если же один из уровней сигнала в манчестерском коде нулевой (как, например, в сети Ethernet), то величина постоянной составляющей в течение передачи будет равна примерно половине амплитуды сигнала. Это позволяет легко фиксировать столкновения пакетов в сети (конфликт, коллизию) по отклонению величины постоянной составляющей за установленные пределы.
Частотный спектр сигнала при манчестерском кодировании включает в себя только две частоты: при скорости передачи 10 Мбит/с это 10 МГц (соответствует передаваемой цепочке из одних нулей или из одних единиц) и 5 МГц (соответствует последовательности из чередующихся нулей и единиц: 1010101010...). Поэтому с помощью простейших полосовых фильтров можно легко избавиться от всех других частот (помехи, наводки, шумы).
Бифазный код
Бифазный код часто рассматривают как разновидность манчестерского, так как их характеристики практически полностью совпадают.
Данный код отличается от классического манчестерского кода тем, что он не зависит от перемены мест двух проводов кабеля. Особенно это удобно в случае, когда для связи применяется витая пара, провода которой легко перепутать. Именно этот код используется в одной из самых известных сетей Token-Ring компании IBM.
Принцип данного кода прост: в начале каждого битового интервала сигнал меняет уровень на противоположный предыдущему, а в середине единичных (и только единичных) битовых интервалов уровень изменяется еще раз. Таким образом, в начале битового интервала всегда есть переход, который используется для самосинхронизации. Как и в случае классического манчестерского кода, в частотном спектре при этом присутствует две частоты. При скорости 10 Мбит/с это частоты 10 МГц (при последовательности одних единиц: 11111111...) и 5 МГц (при последовательности одних нулей: 00000000...).
Имеется также еще один вариант бифазного кода (его еще называют дифференциальным манчестерским кодом). В этом коде единице соответствует наличие перехода в начале битового интервала, а нулю – отсутствие перехода в начале битового интервала (или наоборот). При этом в середине битового интервала переход имеется всегда, и именно он служит для побитовой самосинхронизации приемника. Характеристики этого варианта кода также полностью соответствуют характеристикам манчестерского кода.
Здесь же стоит упомянуть о том, что часто совершенно неправомерно считается, что единица измерения скорости передачи бод – это то же самое, что бит в секунду, а скорость передачи в бодах равняется скорости передачи в битах в секунду. Это верно только в случае кода NRZ. Скорость в бодах характеризует не количество передаваемых бит в секунду, а число изменений уровня сигнала в секунду. И при RZ или манчестерском кодах требуемая скорость в бодах оказывается вдвое выше, чем при NRZ. В бодах измеряется скорость передачи сигнала, а в битах в секунду – скорость передачи информации. Поэтому, чтобы избежать неоднозначного понимания, скорость передачи по сети лучше указывать в битах в секунду (бит/с, Кбит/с, Мбит/с, Гбит/с).
Другие коды
Все разрабатываемые в последнее время коды призваны найти компромисс между требуемой при заданной скорости передачи полосой пропускания кабеля и возможностью самосинхронизации. Разработчики стремятся сохранить самосинхронизацию, но не ценой двукратного увеличения полосы пропускания, как в рассмотренных RZ, манчестерском и бифазном кодах.
Чаще всего для этого в поток передаваемых битов добавляют биты синхронизации. Например, один бит синхронизации на 4, 5 или 6 информационных битов или два бита синхронизации на 8 информационных битов. В действительности все обстоит несколько сложнее: кодирование не сводится к простой вставке в передаваемые данные дополнительных битов. Группы информационных битов преобразуются в передаваемые по сети группы с количеством битов на один или два больше. Приемник осуществляет обратное преобразование, восстанавливает исходные информационные биты. Довольно просто осуществляется в этом случае и обнаружение несущей частоты (детектирование передачи).
Так, например, в сети FDDI (скорость передачи 100 Мбит/с) применяется код 4В/5В, который 4 информационных бита преобразует в 5 передаваемых битов. При этом синхронизация приемника осуществляется один раз на 4 бита, а не в каждом бите, как в случае манчестерского кода. Но зато требуемая полоса пропускания увеличивается по сравнению с кодом NRZ не в два раза, а только в 1,25 раза (то есть составляет не 100 МГц, а всего лишь 62,5 МГц). По тому же принципу строятся и другие коды, в частности, 5В/6В, используемый в стандартной сети 100VG-AnyLAN, или 8В/10В, применяемый в сети Gigabit Ethernet.
В сегменте 100BASE-T4 сети Fast Ethernet использован несколько иной подход. Там применяется код 8В/6Т, предусматривающий параллельную передачу трех трехуровневых сигналов по трем витым парам. Это позволяет достичь скорости передачи 100 Мбит/с на дешевых кабелях с витыми парами категории 3, имеющих полосу пропускания всего лишь16 МГц (см. табл. 2.1). Правда, это требует большего расхода кабеля и увеличения количества приемников и передатчиков. К тому же принципиально, чтобы все провода были одной длины и задержки сигнала в них не слишком различались.
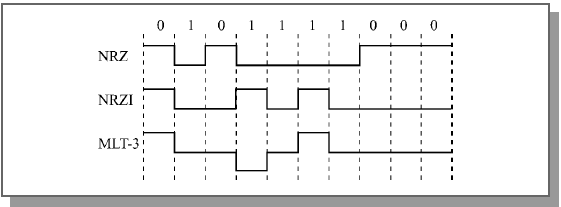
Иногда уже закодированная информация подвергается дополнительному кодированию, что позволяет упростить синхронизацию на приемном конце. Наибольшее распространение для этого получили 2-уровневый код NRZI, применяемый в оптоволоконных сетях (FDDI и 100BASE-FX), а также 3-уровневый код MLT-3, используемый в сетях на витых парах (TPDDI и 100BASE-TХ). Оба эти кода (рис. 3.17) не являются самосинхронизирующимися.
Коды NRZI и MLT-3
Рис. 3.17. Коды NRZI и MLT-3
Код NRZI (без возврата к нулю с инверсией единиц – Non-Return to Zero, Invert to one) предполагает, что уровень сигнала меняется на противоположный в начале единичного битового интервала и не меняется при передаче нулевого битового интервала. При последовательности единиц на границах битовых интервалов имеются переходы, при последовательности нулей – переходов нет. В этом смысле код NRZI лучше синхронизируется, чем NRZ (там нет переходов ни при последовательности нулей, ни при последовательности единиц).
Код MLT-3 (Multi-Level Transition-3) предполагает, что при передаче нулевого битового интервала уровень сигнала не меняется, а при передаче единицы – меняется на следующий уровень по такой цепочке: +U, 0, –U, 0, +U, 0, –U и т.д. Таким образом, максимальная частота смены уровней получается вчетверо меньше скорости передачи в битах (при последовательности сплошных единиц). Требуемая полоса пропускания оказывается меньше, чем при коде NRZ.
Все упомянутые в данном разделе коды предусматривают непосредственную передачу в сеть цифровых двух- или трехуровневых прямоугольных импульсов.
Однако иногда в сетях используется и другой путь – модуляция информационными импульсами высокочастотного аналогового сигнала (синусоидального). Такое аналоговое кодирование позволяет при переходе на широкополосную передачу существенно увеличить пропускную способность канала связи (в этом случае по сети можно передавать несколько бит одновременно). К тому же, как уже отмечалось, при прохождении по каналу связи аналогового сигнала (синусоидального) не искажается форма сигнала, а только уменьшается его амплитуда, а в случае цифрового сигнала форма сигнала искажается (см. рис. 3.2).
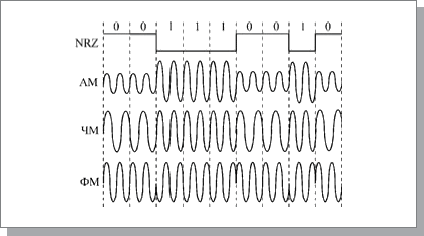
К самым простым видам аналогового кодирования относятся следующие (рис. 3.18):
* Амплитудная модуляция (АМ, AM – Amplitude Modulation), при которой логической единице соответствует наличие сигнала (или сигнал большей амплитуды), а логическому нулю – отсутствие сигнала (или сигнал меньшей амплитуды). Частота сигнала при этом остается постоянной. Недостаток амплитудной модуляции состоит в том, что АМ-сигнал сильно подвержен действию помех и шумов, а также предъявляет повышенные требования к затуханию сигнала в канале связи. Достоинства – простота аппаратурной реализации и узкий частотный спектр.
Аналоговое кодирование цифровой информации
Рис. 3.18. Аналоговое кодирование цифровой информации
* Частотная модуляция (ЧМ, FM – Frequency Modulation), при которой логической единице соответствует сигнал более высокой частоты, а логическому нулю – сигнал более низкой частоты (или наоборот). Амплитуда сигнала при частотной модуляции остается постоянной, что является большим преимуществом по сравнению с амплитудной модуляцией.
* Фазовая модуляция (ФМ, PM – Phase Modulation), при которой смене логического нуля на логическую единицу и наоборот соответствует резкое изменение фазы синусоидального сигнала одной частоты и амплитуды. Важно, что амплитуда модулированного сигнала остается постоянной, как и в случае частотной модуляции.
Применяются и значительно более сложные методы модуляции, являющиеся комбинацией перечисленных простейших методов. Чаще всего аналоговое кодирование используется при передаче информации по каналу с узкой полосой пропускания, например, по телефонным линиям в глобальных сетях. Кроме того, аналоговое кодирование применяется в радиоканалах, что позволяет обеспечивать связь между многими пользователями одновременно. В локальных кабельных сетях аналоговое кодирование практически не используется из-за высокой сложности и стоимости как кодирующего, так и декодирующего оборудования.
Кроме кабельных каналов в компьютерных сетях иногда используются также бескабельные каналы. Их главное преимущество состоит в том, что не требуется никакой прокладки проводов (не надо делать отверстий в стенах, закреплять кабель в трубах и желобах, прокладывать его под фальшполами, над подвесными потолками или в вентиляционных шахтах, искать и устранять повреждения). К тому же компьютеры сети можно легко перемещать в пределах комнаты или здания, так как они ни к чему не привязаны.
Радиоканал использует передачу информации по радиоволнам, поэтому теоретически он может обеспечить связь на многие десятки, сотни и даже тысячи километров. Скорость передачи достигает десятков мегабит в секунду (здесь многое зависит от выбранной длины волны и способа кодирования).
Особенность радиоканала состоит в том, что сигнал свободно излучается в эфир, он не замкнут в кабель, поэтому возникают проблемы совместимости с другими источниками радиоволн (радио- и телевещательными станциями, радарами, радиолюбительскими и профессиональными передатчиками и т.д.). В радиоканале используется передача в узком диапазоне частот и модуляция информационным сигналом сигнала несущей частоты.
Главным недостатком радиоканала является его плохая защита от прослушивания, так как радиоволны распространяются неконтролируемо. Другой большой недостаток радиоканала – слабая помехозащищенность.
Для локальных беспроводных сетей (WLAN – Wireless LAN) в настоящее время применяются подключения по радиоканалу на небольших расстояниях (обычно до 100 метров) и в пределах прямой видимости. Чаще всего используются два частотных диапазона – 2,4 ГГц и 5 ГГц. Скорость передачи – до 54 Мбит/с. Распространен вариант со скоростью 11 Мбит/с.
Сети WLAN позволяют устанавливать беспроводные сетевые соединения на ограниченной территории (обычно внутри офисного или университетского здания или в таких общественных местах, как аэропорты). Они могут использоваться во временных офисах или в других местах, где прокладка кабелей неосуществима, а также в качестве дополнения к имеющейся проводной локальной сети, призванного обеспечить пользователям возможность работать перемещаясь по зданию.
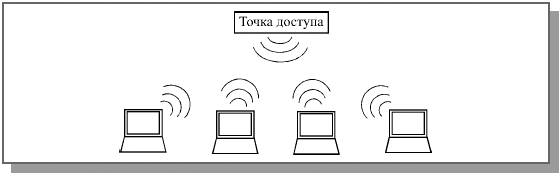
Популярная технология Wi-Fi (Wireless Fidelity) позволяет организовать связь между компьютерами числом от 2 до 15 с помощью концентратора (называемого точкой доступа, Access Point, AP), или нескольких концентраторов, если компьютеров от 10 до 50. Кроме того, эта технология дает возможность связать две локальные сети на расстоянии до 25 километров с помощью мощных беспроводных мостов. Для примера на рис. 2.7 показано объединение компьютеров с помощью одной точки доступа. Важно, что многие мобильные компьютеры (ноутбуки) уже имеют встроенный контроллер Wi-Fi, что существенно упрощает их подключение к беспроводной сети.
Объединение компьютеров с помощью технологии Wi-Fi
Рис. 2.7. Объединение компьютеров с помощью технологии Wi-Fi
Радиоканал широко применяется в глобальных сетях как для наземной, так и для спутниковой связи. В этом применении у радиоканала нет конкурентов, так как радиоволны могут дойти до любой точки земного шара.
Инфракрасный канал также не требует соединительных проводов, так как использует для связи инфракрасное излучение (подобно пульту дистанционного управления домашнего телевизора). Главное его преимущество по сравнению с радиоканалом – нечувствительность к электромагнитным помехам, что позволяет применять его, например, в производственных условиях, где всегда много помех от силового оборудования. Правда, в данном случае требуется довольно высокая мощность передачи, чтобы не влияли никакие другие источники теплового (инфракрасного) излучения. Плохо работает инфракрасная связь и в условиях сильной запыленности воздуха.
Скорости передачи информации по инфракрасному каналу обычно не превышают 5—10 Мбит/с, но при использовании инфракрасных лазеров может быть достигнута скорость более 100 Мбит/с. Секретность передаваемой информации, как и в случае радиоканала, не достигается, также требуются сравнительно дорогие приемники и передатчики. Все это приводит к тому, что применяют инфракрасные каналы в локальных сетях довольно редко. В основном они используются для связи компьютеров с периферией (интерфейс IrDA).
Инфракрасные каналы делятся на две группы:
* Каналы прямой видимости, в которых связь осуществляется на лучах, идущих непосредственно от передатчика к приемнику. При этом связь возможна только при отсутствии препятствий между компьютерами сети. Зато протяженность канала прямой видимости может достигать нескольких километров.
* Каналы на рассеянном излучении, которые работают на сигналах, отраженных от стен, потолка, пола и других препятствий. Препятствия в данном случае не помеха, но связь может осуществляться только в пределах одного помещения.
Если говорить о возможных топологиях, то наиболее естественно все беспроводные каналы связи подходят для топологии типа шина, в которой информация передается одновременно всем абонентам. Но при использовании узконаправленной передачи и/или частотного разделения по каналам можно реализовать любые топологии (кольцо, звезда, комбинированные топологии) как на радиоканале, так и на инфракрасном канале.
Прародителем сети интернет была сеть ARPANET. Первоначально её разработка финансировалась Управлением перспективного планирования (Advanced Research Projects Agency, или ARPA). Проект стартовал осенью 1968 года и уже в сентябре 1969 года в опытную эксплуатацию был запущен первый участок сети ARPANET.
Сеть ARPANET долгое время являлась тестовым полигоном для исследования сетей с коммутацией пакетов. Однако кроме исследовательских, ARPANET служила и чисто практическим целям. Ученые нескольких университетов, а также сотрудники некоторых военных и государственных исследовательских институтов регулярно её использовали для обмена файлами и сообщениями электронной почты, а так же для работы на удалённых компьютерах. В 1975 году управление сетью было выведено из под контроля ARPA и поручено управлению связи Министерства обороны США. Для военных данная сеть представляла большой интерес, так как позволяла сохранять её работоспособность даже при уничтожении её части, например, при ядерном ударе.
В 1983 году Министерство обороны разделило ARPANET на две связанные сети. При этом за сетью ARPANET были сохранены её исследовательские функции, а для военных целей была сформирована новая сеть, которую назвали MILNET. Физически сеть ARPANET состояла приблизительно из 50 миникомпьютеров типа С30 и С300, выпущенных фирмой BBN Corporation. Они назывались узлами коммутации пакетов и были разбросаны по территории материковой части США и Западной Европы. Сеть MILNET состояла приблизительно из 160 узлов, причём 34 из них были расположены в Европе, а 18 в Тихом Океане и в Азиатско-Тихоокеанском регионе. Сами узлы коммутации пакетов нельзя было использовать для решения вычислительных задач общего плана.
Понимая, что в ближайшем будущем очень важным моментом в научных исследованиях будет процесс обмена данными, Национальный научный фонд (NFS) в 1987 году основал отделение сетевых и коммуникацинных исследований и инфраструктуры. В его задачи входило обеспеченье современными сетевыми коммуникационными средствами учёных и инженеров США. И хотя отделение фонда NFS финансировало основные исследовательские программы в области сетевых коммуникаций, сферой его основных интересов было расширение Internet.
Сеть NSFNET строилась в несколько этапов и быстро преобретала популярность не только в научно-исследовательских кругах, но и в коммерческой среде. К 1991 году фонд NFS и другие государственные учреждения США поняли, что масштабы Internet вышли далеко за отведённые её на этапе разработки рамки университетской и научной сети. К Internet стало подключаться множество организаций, разбросанных по всему Земному шару. Трафик в магистральном канале NSFNET вырос почти до миллиарда пакетов в день, и его пропускной способности 1.5 Мбит/с на отдельных участках стало уже не хватать. Поэтому правительство США начало проводить политику приватизации и коммерческого использования Internet. Фонд NFS принял решение предать магистральную сеть на попечение закрытой акционерной компании и оплачивать доступ к ней для государственных научных и исследовательских организаций.
Семейство TCP/IP
Познакомившись с историей, давайте подробнее рассмотрим, что собой представляют протоколы TCP/IP. TCP/IP - это семейство сетевых протоколов, ориентированных на совместную работу. В состав семейства входит несколько компонентов:
IP (Internet Protocol - межсетевой протокол) - обеспечивает транспортировку пакетов данных с одного компьютера на другой;
ICMP (Internet Control Message Protocol - протокол управляющих сообщений в сети Internet) - отвечает за различные виды низкоуровневой поддержки протокола IP, включая сообщения об ошибках, вспомогательные маршрутизирующие запросы и подтверждения о получении сообщений;
ARP (Address Resolution Protocol - протокол преобразования адресов) - выполняет трансляцию IP-адресов в аппаратные MAC-адреса;
UDP (User Datagram Protocol - протокол передачи дейтаграмм пользователя) и TCP (Transmission Control Protocol - протокол управления передачей) - обеспечивают доставку данных конкретным приложениям на указанном компьютере. Протокол UDP реализует передачу отдельных сообщений без подтверждения доставки, тогда как TCP гарантирует надёжный полнодуплексный канал связи между процессами на двух разных компьютерах с возможностью управления потоком и контроля ошибок.
Протокол представляет собой набор правил, использующихся для при обмене данными между двумя компьютерами. В нём оговариваются формат блоков сообщений, описывается реакция компьютера на получение определённого типа сообщения и указываются способы обработки ошибок и других необычных ситуаций. И что самое важное, благодаря протоколам, мы можем описать процесс обмена данными между компьютерами, не привязываясь к какой-то определённой комьютерной платформе или сетевому оборудованию конкретного производителя.
Сокрытие низкоуровневых особенностей процесса передачи данных способствует повышению производительности труда разработчиков. Во-первых, поскольку программистам приходится иметь дело с протоколами, относящимися к достаточно высокому уровню абстракции, им не нужно держать в голове (и даже изучать!) технические подробности испольуемого аппаратного обеспечения. Во-вторых, поскольку программы разрабатываются на основе модели, относящейся к высокому уровню абстракции, который не зависит от конкретной архитектуры компьютера или типа сетевого оборудования, в них не нужно вносить никаких изменений при переходе на другой тип оборудования или изменений конфигурации сети.
Замечание Говорить о том, что ARP входит в состав семейства протоколов TCP/IP не совсем корректно. Однако это неотъемлемая часть стека протоколов в сетях Ethernet. Для того чтобы отправить данные по сети, IP-адрес хоста должен быть преобразован в физический адрес машины получателя (уникальный адрес сетевой платы). Протокол ARP как раз и предназначен для такой цели.
Самым фундаментальным протоколом Интернета является протокол IP (от англ. Internet Protocol), обеспечивающий передачу данных между двумя удаленными компьютерами. Протокол IP является достаточно простым, и обеспечивает адресацию в сети. В ранних сетях адреса в сети были уникальные целые цифры, сейчас сеть построена по иерархическому принципу.
Стек протоколов TCP/IP имеет четыре основных уровня, поэтому часто говорят, что TCP/IP — это четырехуровневый стек протоколов. Внизу стека расположен интерфейсный уровень, посредством которого происходит связь с аппаратурой. За ним следует уровень IP, поверх которого построены транспортные протоколы TCP и UDP. На вершине стека находится уровень приложений, таких как ftp, telnet и т. д. Как мы уже говорили, IP — это простой протокол, не требующий установления соединения. При отсылке пакета данных, IP, как и все протоколы без соединения, послав пакет, тут же "забывает" о нем. При приеме пакетов с верхних уровней стека, этот протокол обертывает их в IP-пакет и передает необходимому аппаратному обеспечению для отправки в сеть. Однако именно в такой простоте и заключается основное достоинство протокола IP. Дело в том, что поскольку IP является простым протоколом, он никак не связан со структурой физической среды, по которым передаются данные. Для протокола IP главное, что эта физическая среда в принципе способна к передаче пакетов. Поэтому IP работает как в локальных, так и в глобальных сетях, как в синхронном, так и в асинхронном режиме передачи данных, как в обычных линиях связи, так и беспроводных и т. д. А поскольку протокол IP является фундаментом четырехуровнего сте-ка протоколов, то все семейство протоколов TCP/IP также может функционировать в любой сети с любым режимом передачи пакетов.
На сетевом уровне в семействе протоколов TCP/IP предусмотрено два обширных класса служб, которые используются во всех приложениях.
Служба доставки пакетов, не требующая установки соединения.
Надёжная потоковая транспортная служба.
Различие между службами, требующими установления надёжного соединения и службами, не требующими этого, является одним из самых основных вопросов сетевого программирования. Первое, на что следует обратить внимание, это то, что когда мы говорим об установлении соединения, то имеется в виду не соединение между компьютерами посредством физического носителя, а о способе передачи данных по этому носителю. Основное различие состоит в том, что службы, в которых устанавливается надёжное соединение, сохраняют информацию о состоянии и таким образом отслеживают информацию о передаваемых пакетах. В службах же, не требующих надёжного соединения, пакеты передаются независимо друг от друга.
Данные передаются по сети в форме пакетов, имеющих максимальный размер, определяемый ограничениями канального уровня. Каждый пакет состоит из заголовка и полезного содержимого (сообщения). Заголовок включает сведения о том, откуда прибыл пакет и куда он направляется. Заголовок, кроме того, может содержать контрольную сумму, информацию, характерную для конкретного протокола, и другие инструкции, касающиеся обработки пакета. Полезное содержимое – это данные, подлежащие пересылке.
Имя базового блока передачи данных зависит от уровня протокола. На канальном уровне это кадр или фрейм, в протоколе IP – пакет, а в протоколе TCP – сегмент. Когда пакет передаётся вниз по стеку протоколов, готовясь к отправке, каждый протокол добавляет в него свой собственный заголовок. Законченный пакет одного протокола становится полезным содержимым пакета, генерируемого следующим протоколом.
Определение
Пакеты, которые посылаются протоколом, не требующим соединения, называются дейтаграммами.
Каждая дейтаграмма является уникальной в том смысле, что никак не зависит от других. Как правило, при работе с протоколами без установления соединения, диалог между клиентом и сервером предельно прост: клиент посылает одиночный запрос, а сервер на него отвечает. При этом каждый новый запрос — это новая транзакция, т. е. инициируемые клиентом запросы никак не связаны друг с другом с точки зрения протокола. Протоколы без установления соединения ненадежны в том смысле, что нет никаких гарантий, что отправленный пакет будет доставлен по месту назначения.
Протоколами, требующие установления логического соединения, сохраняют информацию о состоянии, что позволяет обеспечивать надежную доставку пересылаемых данных. Когда говорится о сохранении состояния, имеется ввиду то, что между отправителем и получателем происходит обмен информацией о ходе выполнения передачи данных. К примеру, отправитель, посылая данные, сохраняет информацию о том, какие данные он послал. После этого в течении определенного времени он ожидает информацию от получателя о доставке этих данных, и, если такая информация не поступает, данные пересылаются повторно.
Работа протокола с установлением соединения включает в себя три основные фазы:
установление соединения;
обмен данными;
разрыв соединения.
Передача всех данных при работе с таким протоколом, в отличие от протокола без установления соединения, происходит за одну транзакцию, т. е. в фазе обмена данными не происходит обмена адресами между отправителем и получателем, поскольку эта информация передается на этапе установки соединения. Возвращаясь к телефонной аналогии, можно сказать, что нам в этом случае нет необходимости для того, чтобы сказать собеседнику очередное слово, вновь набирать его номер и устанавливать соединение. Заметим, что приводимая аналогия имеет одну неточность. Дело в том, что при телефонном разговоре все же устанавливается физическое соединение. Когда же мы говорим о соединении с точки зрения протоколов, то это соединение, скорее, умозрительное. К примеру, если вдруг при телефонном разговоре, неожиданно сломается телефонный аппарат вашего собеседника, вы тут же узнаете об этом, поскольку разговор незамедлительно прервется. А вот если происходит обмен данными между двумя хостами и один из них вдруг аварийно остановится, то для его "хоста-собеседника" соединение по прежнему будет существовать, поскольку для него не произошло ничего такого, что сделало бы недействительной хранящуюся у него информацию о состоянии.
В этом смысле работу с протоколом, требующим установления логического соединения можно сравнить с телефонным разговором. Когда мы звоним по телефону, мы сначала набираем номер (установление соединения), затем разговариваем (обмен данными) и по окончании разговора вешаем трубки (разрыв соединения).
Протокол без установления соединения обычно сравниваю с почтовой открыткой. Каждая открытка представляет собой самостоятельную единицу (пакет информации или дейтаграмму), которая обрабатывается в почтовом отделении независимо от других открыток. При этом на почте не отслеживается состояние переписки между двумя респондентами и, как правило, нет никакой гарантии, что ваша открытка попадет к адресату. Если на открытке указан неправильный адрес, она никогда не дойдет до получателя, и не возвратиться обратно к отправителю. А если вы захотите отправить вашему собеседнику новую порцию информации, то это уже будет другая транзакция, поскольку нужно будет писать новую открытку, указывать на ней адрес и т. д.
Как видим, у протоколов без установления соединения существует много недостатков и может возникнуть вопрос о надобности таких протоколов. Однако, использование проколов без установления логического соединения все-таки оправдано. Как правило, при помощи таких протоколов организуется связь одного хоста со многими другими, в то время как при использовании протоколов с установлением соединения связь организуется между парой хостов (по одному соединению на каждую пару). Важный момент заключается в том, что протоколы без установления логического соединения являются фундаментом, на котором строятся более сложные протоколы. К примеру, протокол TCP построен на базе протокола IP.
Протоколы транспортного уровня
Протоколами транспортного уровня в четырехуровневом стеке протоколов являются протоколы TCP и UDP.
Давайте рассмотрим, каким образом функционирует протокол TCP. Дело в том, что поскольку TCP-пакеты, иначе называемые сегментами, посылаются при помощи протокола IP, у TCP нет никакой информации о состоянии этих пакетов. Поэтому для того, чтобы хранить информацию о состоянии, TCP к базовому протоколу IP добавляет три параметра.
Во-первых, добавляется сегмент контрольной суммы содержащихся в пакете данных, что позволяет убедиться в том, что в принципе все данные дошли до получателя и не повредились во время транспортировки.
Во-вторых, к каждому передаваемому байту приписывается порядковый номер, что необходимо для определения того, совпадает ли порядок прибытия данных с порядком их отправки. И даже в том случае, если данные пришли не в том порядке, в котором были отправлены, наличие порядковых номеров позволит получателю правильно составить из этих данных исходное сообщение.
В-третьих, базовый протокол IP дополняется также механизмами подтверждения получения данных и повторной отправки, на тот случай, если данные не были доставлены.
Если с первыми двумя параметрами все более-менее понятно, то механизм подтверждения/повторной отправки достаточно сложен и его мы рассмотрим подробнее в другой раз.
Зачастую на Web – сайтах можно встретить страницы с размещенными на них HTML - формами. Веб-формы – удобный способ получения информации от посетителей вашего сайта. Пример тому – гостевая книга, – которая обеспечивает обратную связь с посетителями и разработчиками сайта. Формы так же удобны и для разработчиков сайта при разработке CMS, которая позволяет поддерживать главное свойство сайта - актуальность. Данная статья посвящена основам создания HTML-форм, их обработке и способам передачи данных из экранных форм в PHP-сценарии.
1) Создание простой формы
Теги <form> и </form> задают начало и конец формы. Начинающий форму тег <form> содержит два атрибута: action и method. Атрибут action содержит адрес URL сценария, который должен быть вызван для обработки сценария. Атрибут method указывает браузеру, какой вид HTTP запроса необходимо использовать для отправки формы; возможны значения POST и GET.
Замечание Главное отличие методов POST и GET заключается в способе передачи информации. В методе GET параметры передаются через адресную строку, т.е. по сути в HTTP-заголовке запроса, в то время как в методе POST параметры передаются через тело HTTP-запроса и никак не отражаются на виде адресной строки.
2) Флажок (checkbox)
Флажки checkbox предлагаю пользователю ряд вариантов, и разрешает выбор нескольких из них.
Группа флажков состоит из элементов <input>, имеющих одинаковые атрибуты name и type(checkbox). Если вы хотите, чтобы элемент был отмечен по умолчанию необходимо пометить его как checked. Если элемент выбран, то сценарию поступит строка имя=значение, в противном случае в обработчик формы не придет ничего, т.е. не выбранные флажки вообще никак не проявляют себя в переданном наборе данных.
Пример:
3) Переключатель(radio)
Переключатели radio предлагают пользователю ряд вариантов, но разрешает выбрать только один из них.
Переключатель (radio) имеет атрибуты name, type и value. Атрибут name задает имя переключателя, type задает тип radio, а атрибут value задает значение. Если пользователь выберет переключатель, то сценарию будет передана строка имя=значение. При необходимости можно указать параметр checked, который указывает на то, что перключатель будет иметь фокус (т.е. будет отмечен по умолчанию) при загрузке страницы. Переключатели также можно объединять в группы, для этого они должны иметь одно и тоже имя.
Пример:
4) Кнопка сброса формы(Reset)
При нажатии на кнопку сброса(reset), все элементы формы будут установлены в то состояние, которое было задано в атрибутах по умолчанию, причем отправка формы не производиться.
Пример:
5) Выпадающий список (select)
Тэг <select> представляет собой выпадающий или раскрытый список, при этом одновременно могут быть выбраны одна или несколько строк.
Список начинается с парных тегов <select></select>. Теги <option></option> позволяют определить содержимое списка, а параметр value определяет значение строки. Если в теге <option> указан параметр selected, то строка будет изначально выбранной. Параметр size задает, сколько строк будет занимать список. Если size равен 1, то список будет выпадающим. Если указан атрибут multiple, то разрешено выбирать несколько элементов из списка(при size = 1 не имеет смысла).
При передаче данных выпадающего списка сценарию передается строка имя=значение, а при раскрытом списке передается строка имя=значение1&имя=значение2&имя=значениеN.
6) Текстовое поле (text)
Позволяет пользователям вводить различную информацию.
При создании обычного текстового поля размером size и максимальной допустимой длины maxlength символов, атрибут type принимает значение text. Если указан параметр value, то поле будет содержать отображать value-текст. При создании поля не забывайте указывать имя поля, т.к. этот атрибут является обязательным.
Пример:
7) Поле для ввода пароля (password)
Полностью аналогичен текстовому полю, за исключением того что символы, набираемые пользователем, не будут отображаться на экране.
Пример:
8) Многострочное поле ввода текста (textarea)
Многострочное поле ввода текста позволяет отправлять не одну строку, а сразу несколько. По умолчанию тег создает пустое поле шириной в 20 символов и состоящее из двух строк.
Многострочное поле ввода текста начинается с парных тегов <textarea></textarea>. Тэг name задает имя многострочного поля. Также можно указать ширину поля(cols) и число строк(rows). При необходимости можно указать атрибут readonly, который запрещает редактировать, удалять и изменять текст, т.е. текст будет предназначен только для чтения. Если необходимо чтобы текст был изначально отображен в многострочном поле ввода, то его необходимо поместить между тэгами <textarea></textarea>.
Пример:
9) Скрытое текстовое поле
Позволяет передавать сценарию какую то служебную информацию, не отображая её на странице.
Скрытое поле начинается с тега <input>, атрибуты которого являются name, type и value. Атрибут name задает имя поля, type определяет тип поля, а атрибут value задает значение поля.
Пример:
10) Кнопка отправки формы (submit)
Служит для отправки формы сценарию.
При создании кнопки для отправки формы необходимо указать 2 атрибута: type=“submit” и value=”Текст кнопки”. Атрибут name необходим если кнопка не одна, а несколько и все они созданы для разных операций, например кнопки "Сохранить", "Удалить", "Редактировать" и т.д. После нажатия на кнопку сценарию передается строка имя=текст кнопки.
11) Кнопка для загрузки файлов (browse)
Служит для реализации загрузки файлов на сервер. Объект browse начитается с парных тегов <form></form>. Начинающий тэг <form> содержит необходимый атрибут encrypt. Атрибут encrypt принимает значение multipart/form-data, который извещает сервер о том, что вместе с обычной информацией посылается и файл. При создании текстового поля также необходимо указать тип файла – “file”.
12) Рамка (fieldset)
Объект fieldset позволяет вам нарисовать рамку вокруг объектов. Имеет закрывающий тэг </fieldset>. Заголовок указывается в тэгах <legend></legend>. Основное назначение объекта – задавание различных стилей оформления.
Пример:
Обработка форм
Все данные, которые вы хотите получить из HTML-формы в PHP сценарий обрабатываются с помощью суперглобальных массивов $_POST или $_GET, в зависимости от указанного в атрибуте method метода передачи данных.
Задача: Вам необходимо получить данные из текстового поля и многострочного поля ввода и передать их сценарию.
Решение: Необходимо создать HTML форму и PHP – сценарий для обработки формы.
Обсуждение:
Создадим два файла: form.html и action.php. В файле form.html будет содержаться html-форма с текстовым полем mytext и текстовой областью msg:
В этой html-форме нас интересует 3 атрибута: action который указывает путь к обработчику формы, имя текстового поля (mytext) и имя многострочного поля вода (msg). Также в форме присутствует кнопка, при нажатии на которую происходит передача данных.
После того как html-форма готова нам необходимо создать обработчик формы action.php:
После того как мы введем любые значение в текстовые поля и нажмем на кнопку "Отправить данные" html-форма отправить значения сценарию action.php.
После этого в переменных $text и $msg будут содержаться значения текстового поля и многострочного поля ввода соответственно, значения которых взяты из суперглобальных переменных $_POST.
Если вы хотите, чтобы в многострочном текстовом поле соблюдалось html-форматирование, то используйте функцию nl2br():
Задача: Пусть необходимо создать выпадающий список с годами с 2000 по 2050.
Решение: Необходимо создать HTML форму c элементом SELECT и PHP – сценарий для обработки формы.
Обсуждение:
Для начала создадим два файла: form.html и action.php. В файле form.html будет содержаться html-форма с выпадающим списком. Причем значения в списке можно указать двумя способами:
I. Ввод данных вручную:
II. Ввод данных через цикл:
Как видно, второй пример с циклом, более компактный. Думаю, не стоит приводить скрипт обработчика данной формы, потому что он обрабатывается точно так же как текстовое поле, т.е. значения списка можно извлечь из суперглобального массива $_POST.
Задача: Загрузка файла на сервер
Решение: Необходимо создать HTML форму и PHP – сценарий для обработки файла.
Описание:
Создадим HTML-форму для отправки файла на сервер.
В данной html-форме присутствует элемент browse, который открывает диалоговое окно для выбора файла для загрузки на сервер. При нажатии на кнопку "Передать файл", файл передается сценарию-обработчику.
Затем необходимо написать сценарий обработчик action.php. Перед написание обработчика необходимо определиться в какой каталог мы будет копировать файл:
Замечание Если вы доверяете пользователям закачивать на ваш сервер любые файлы, нужно быть предельно осторожным. Злоумышленники могут внедрить «нехороший» код в картинку или файл и отправить на сервер. В таких случаях нужно жестоко контролировать загрузку файлов.
Данный пример демонстрирует создание каталога и копирование файла в этот каталог на сервер.
Также хотел бы продемонстрировать пример с элементом checkbox. Этот элемент немного отличается от других элементов тем, что если не один из элементов checkbox’a не выбран, то суперглобальная переменная $_POST вернет пустое значение:
Конечно же вы попадали в такую ситуацию, когда приложение, разработанное вами ранее, могло быть снова использовано в рамках другого проекта. Вначале вы конечно же подумали, что это не создаст никаких проблем. Всего-то необходимо скопировать код из одного каталога в другой! Со временем вы осознали, что проекты могут различаться между собой различными параметрами, пусть даже самыми незначительными. Например, это может быть e-mail адрес на который отсылаются сообщения. В таком случае вам ничего не остается, как открыть множество файлов в редакторе и изменить их содержимое, вставляя нужный e-mail при помощи функции найти/заменить. Эта статья расскажет вам о том, как можно избавить себя от подобной работы, а так же порекомендует ряд дополнительных средств для создания и чтения конфигурационных файлов.
Повторное использование кода
Компьютер был изобретен для того, чтобы избавить человека от лишней работы. Развитие компьютерных технологий привело к тому, что человек стал стремиться все меньше времени проводить за компьютером. Допустим, вы программист. Не будь компьютера, вы бы остались без работы. Но в то же время вы стараетесь с помощью компьютера упростить свою ежедневную работы, с этой целью вы используете, например, функцию автозавершения кода в редакторе. Мы хотим подвести вас к той мысли, что код созданный вами, должен быть организован так, чтобы работы по его модификации были сведены к минимуму. Чаще всего это удается, когда вы создаете код, автоматизирующий рутинные операции, такие как создание и прорисовка формы, а так же отправка e-mail. Однако не стоит забывать, что функции для выполнения рутинных операций никогда не бывают на 100% идентичными в различных приложениях. Один формуляр не похож на другой, а сообщения электронной почты предназначены разным адресатам. Однако логика на уровне приложения остается прежней, функции различаются между собой только некоторыми параметрами. Таким образом, вы должны ясно представлять свою цель – разработать код, параметры которого можно было бы определять извне.
Модульная организация
Для решения этой задачи, планируя структуру приложения, вы должны позаботиться о модульности. То есть вам необходимо поместить часто используемые функции или классы в отдельный файл, который будет подключаться через require_once. В этом случае файлы приложения не будут наполнены избыточным кодом. Допустим, вы часто осуществляете запись в лог-файл. В таком случае было бы неплохо код, выполняющий эту операцию, заключить в рамки класса или функции. Будет еще лучше, если вы воспользуетесь уже готовым классом, взятым из какой-нибудь библиотеки исходных кодов, например PEAR.
Параметры процедурального кода
После того, как вы проанализировали код, выделили повторяющиеся фрагменты, распределили их по классам и функциям, необходимо подумать о выделении необходимых параметров, значения которых будут устанавливаться извне. Если речь идет о процедуральном коде, самым простым решением является использование глобальных переменных, которые необходимо определить в отдельном файле. Это позволит в дальнейшем без проблем изменять их значения.
Листинг 1 демонстрирует функцию, которая занимается отправкой e-mail. В ее теле содержится только одна php-функция - mail(). Таким образом, мы избавляемся от необходимости каждый раз указывать получателя при отправке сообщения. Следующая переменная, которую мы определяем, обозначает префикс, предшествующий теме сообщения. Конфигурационный файл, подключаемый через require_once, мог бы выглядеть следующим образом.
Listing 1
Есть способ лучше
Даже если рассмотренный выше способ и является действенным, однако это не самое лучшее решение. По мере того как код вашего приложения будет усложняться, вырастет и число опций, тогда могут возникнуть следующие проблемы:
Глобальные переменные, которые мы используем, могут породить конфликты в пространстве имен.
В том случае, если конфигурационные файлы редактируются не программистом, а дилетантом, в системе могут возникнуть синтаксические ошибки, например из-за незакрытых кавычек.
Для того, чтобы получить доступ к различным переменным, необходимо обращаться к массиву $_GLOBALS.
Вместо php-модулей существуют другие форматы, которые могут быть легко поняты и изменены дилетантами, а так же php-скриптами. Мы имеем в виду два формата: этого широко используемые операционной системой Windows ini-файлы, а так же формат XML.
PHP уже содержит функцию parse_ini_file(), которая без проблем читает ini-файлы. Такой файл имеет очень простую структуру. Каждой опции может быть присвоено только одно значение, а в качестве оператора присваивания используется знак равенства. Конфигурационный файл из предыдущего примера выглядел бы следующим образом в ini-формате.
После считывания ini-файла, имя которого передается в качестве параметра функции parse_ini_file(), мы получаем ассоциативный массив, имеющий вид:
В листинге 2 находится функция отправки почты, основанная на ini-файлах:
Listing 2
Если вы уже прочитали документацию по функции parse_ini_file(), вы кончено же заметили, что она может принимать и второй параметр. Он необходим, если вы хотите разделить ini-файл на несколько разделов или секций. Предположим, вам необходимо сохранить несколько настроек электронной почты. Тогда ini-файл будет выглядеть следующим образом:
"
Если вы при вызове parse_ini_file() передаете true в качестве второго параметра, в этом случае php будет искать в файле секции, а затем вернет многомерный массив, в котором каждой секции (errors и contact) будет соответствовать определенный набор значений:
Особые значения в ini-файлах
При использовании ini-файлов вы должны иметь в виду, что некоторые особые значения могут быть представлены строками. Допустим, вы определяете значение опции как true или yes (без кавычек), в таком случае они автоматически конвертируются в число 1, а false или no – в пустую строку. К сожалению, при этом не генерируется никакой ошибки. Поэтому не пытайтесь использовать no для сок






 Поиск